Die falsche Diagnose kostet Unternehmen Millionen
Jede Woche wird nach einem Halluzinationsvorfall ein weiterer KI-Einsatz in einem Unternehmen zurückgezogen. Ein Rechtsteam erhält eine Vertragszusammenfassung mit erfundenen Klauseln. Eine Finanzabteilung bekommt einen Risikobericht mit frei erfundenen regulatorischen Verweisen. Ein Compliance-Beauftragter stellt fest, dass der eigene KI-Assistent eine Vorschrift zitiert hat, die es nicht gibt.
Der erste Impuls ist, dem Modell die Schuld zu geben. Die Gewichte aktualisieren. Den Anbieter wechseln. Weitere Schutzmechanismen einbauen. Doch in den meisten Fällen ist nicht das Modell das Problem. Sondern die Daten.
Halluzinationen - selbstsicher formulierte, plausibel klingende KI-Ausgaben, die sachlich falsch sind - sind überwiegend ein Versagen der Datenherkunft. Diese Unterscheidung ist keineswegs nur akademisch. Sie bestimmt, wo Organisationen investieren sollten, um KI-Systeme aufzubauen, die tatsächlich vertrauenswürdig sind.
Was Halluzinationen eigentlich sind
Eine Halluzination entsteht, wenn ein KI-Modell eine Ausgabe erzeugt, die nicht auf überprüfbaren Fakten beruht. Die übliche Erklärung lautet, dass das Modell ohne Verständnis 'Muster vervollständigt'. Das ist zutreffend, aber unvollständig.
Die nützlichere Erklärung lautet: Ein Modell kann nur so genau sein wie die Daten, mit denen es trainiert wurde, und in Retrieval-Augmented-Systemen wie die Daten, die es zum Zeitpunkt der Inferenz abruft. Wenn diese Daten eines der folgenden Probleme aufweisen:
- Veraltet - die Vorschriften haben sich geändert, das Modell zitiert noch die alte Fassung
- Manipuliert - eine vorgelagerte Datenquelle wurde unbemerkt verändert
- Widersprüchlich - verschiedene Dokumente widersprechen sich, und das Modell bildet einen Mittelwert
- Ohne Quellenzuordnung - das Modell kann maßgebliche Quellen nicht von minderwertigen unterscheiden
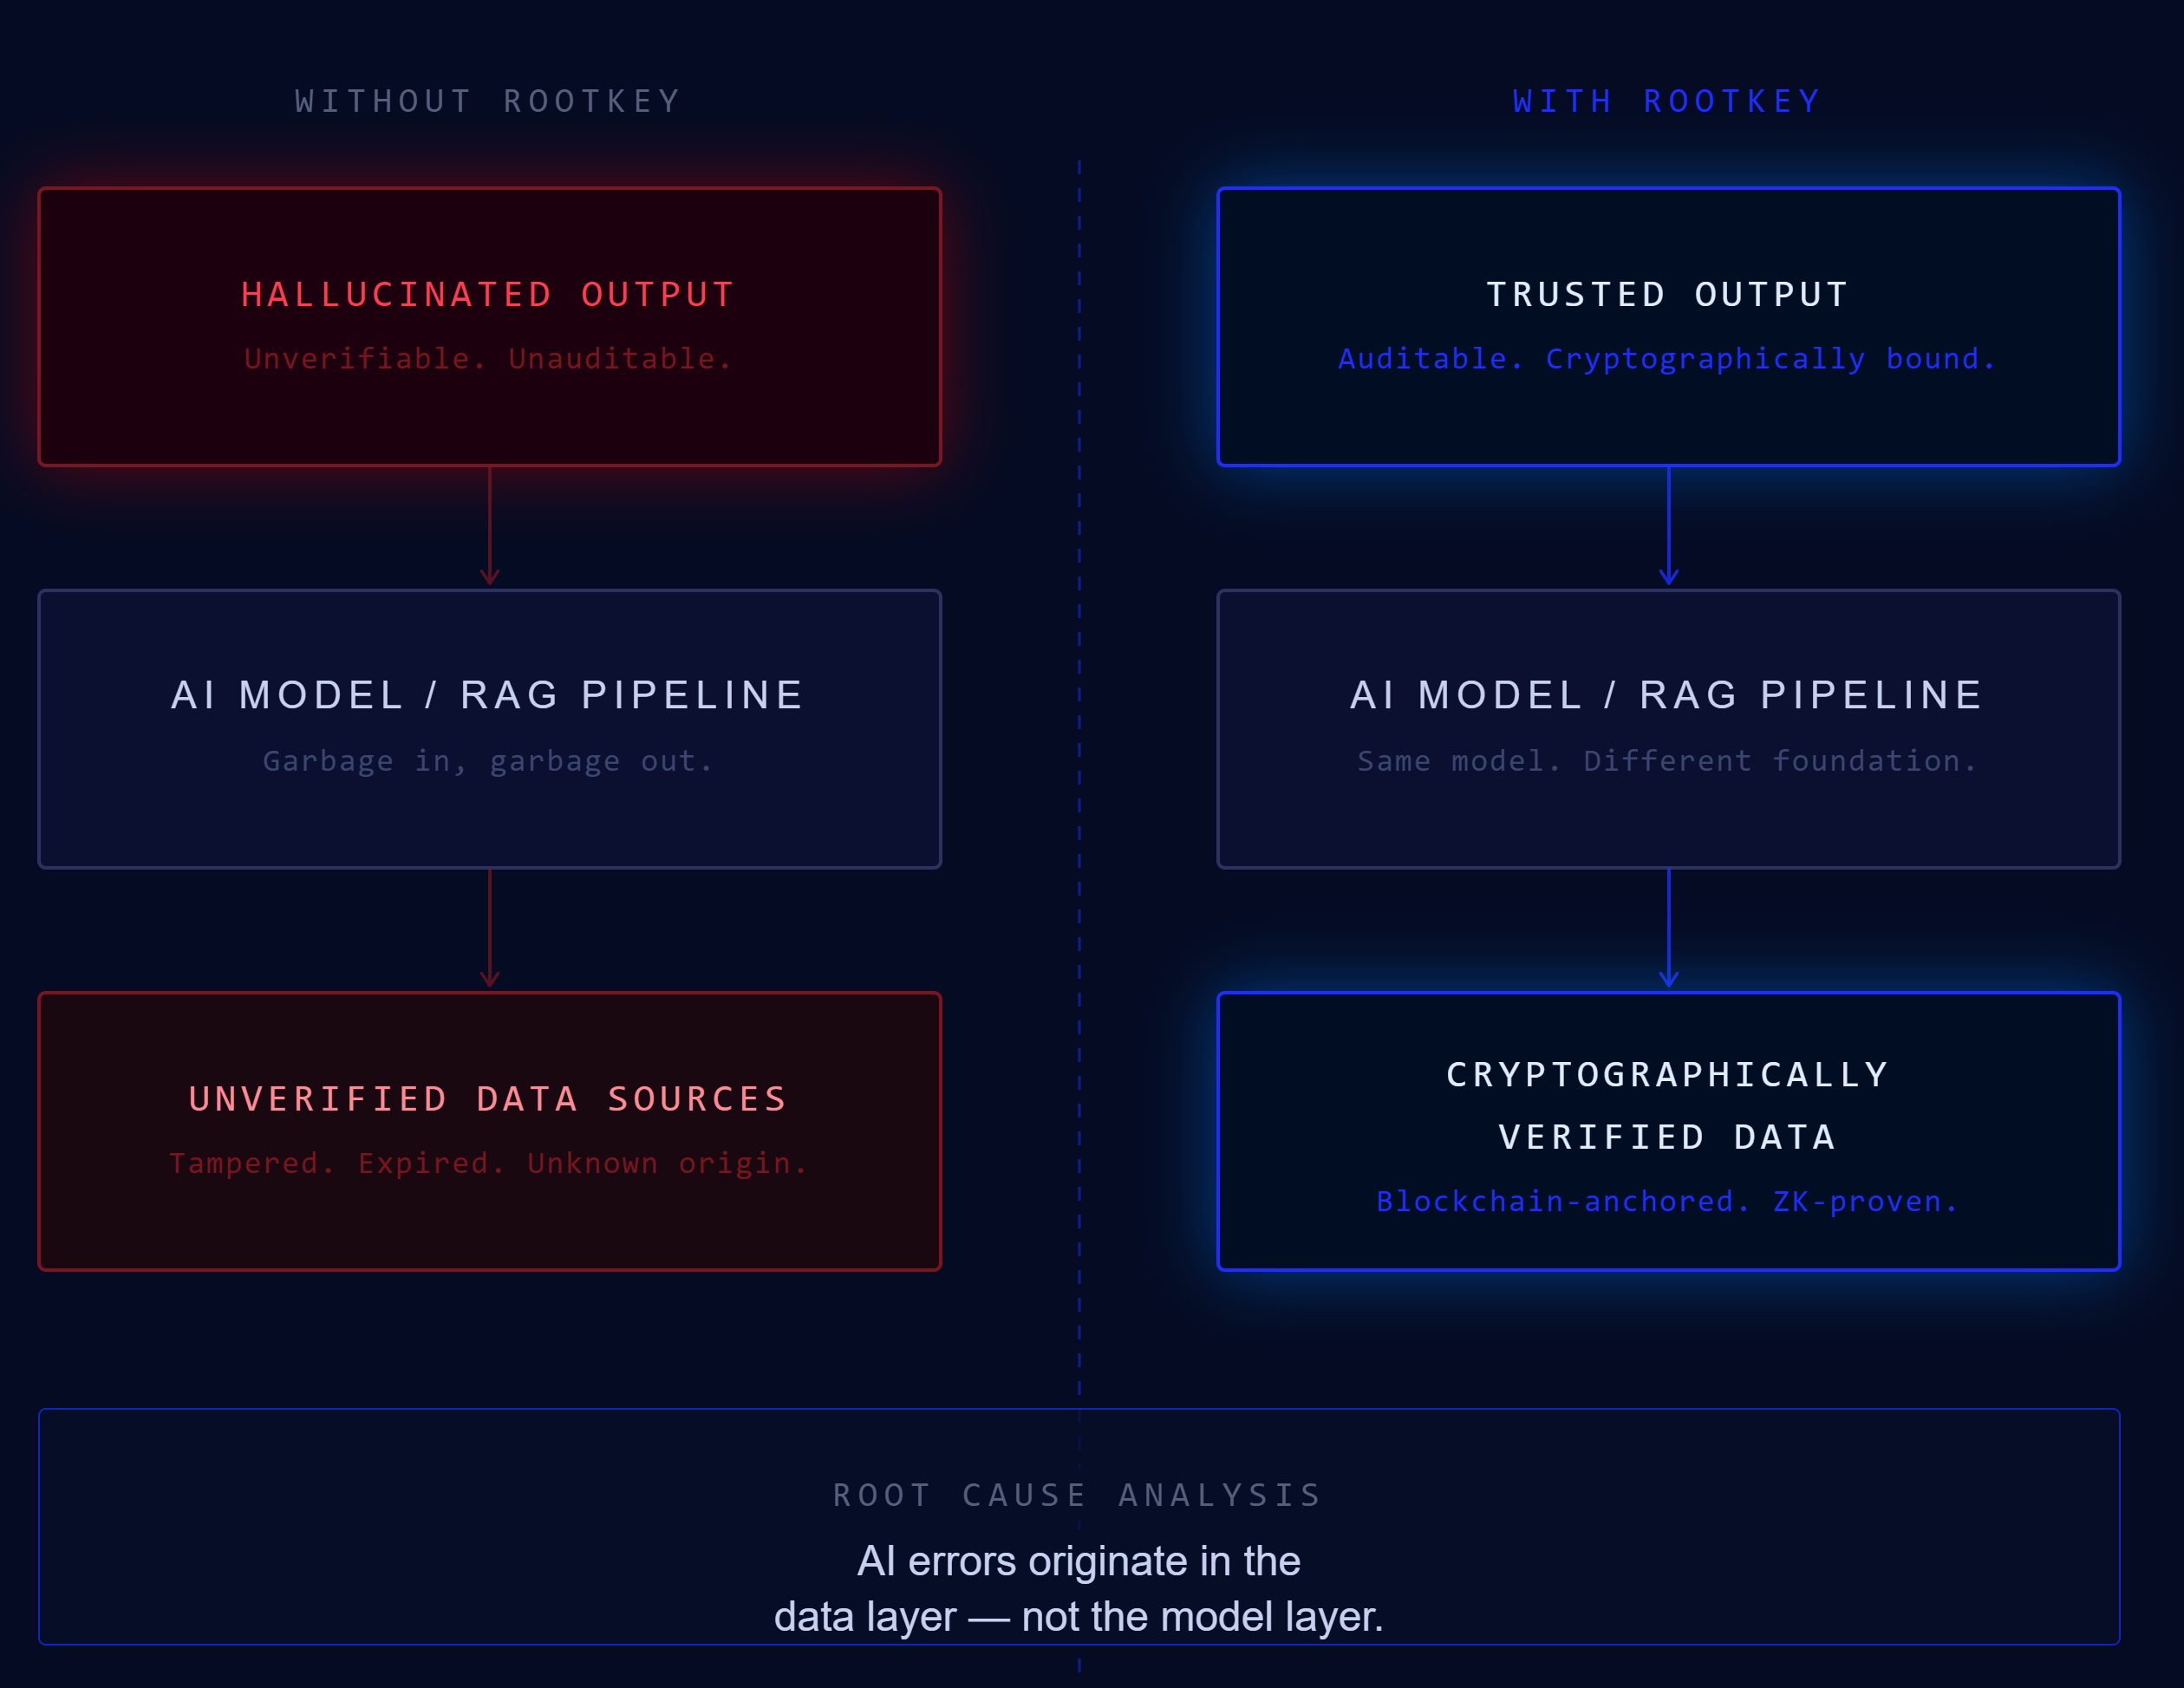
...ist das Ergebnis selbstsicher vorgetragener Unsinn. Das Modell tut genau das, wofür es gebaut wurde - kohärenten, zum Kontext passenden Text erzeugen. Der Fehler liegt weiter vorgelagert, in der Datenschicht.
Das Retrieval-Problem in RAG-Systemen
Systeme für Retrieval-Augmented Generation (RAG) sollten das Halluzinationsproblem lösen, indem sie KI-Ausgaben auf den Abruf von Daten in Echtzeit statt auf statisches Training stützen. Und sie helfen auch - wenn die abgerufenen Daten vertrauenswürdig sind.
Doch die meisten RAG-Implementierungen in Unternehmen rufen Daten aus Dokumentenspeichern, Wissensdatenbanken und internen Datenbanken ab, die keinerlei Ebene zur Integritätsprüfung haben. Es gibt keinen Mechanismus, um zu erkennen, ob ein abgerufenes Dokument seit seiner Indexierung verändert wurde. Keine Möglichkeit zu wissen, ob ein Richtliniendokument letzten Dienstag stillschweigend aktualisiert wurde, ob ein regulatorischer Verweis durch einen Speicherfehler beschädigt wurde oder ob ein Bedrohungsakteur falsche Informationen in den Retrieval-Korpus eingeschleust hat.
Das Ergebnis: Das Modell ruft kompromittierte Daten ab, behandelt sie als maßgeblich und erzeugt mit hoher Konfidenz eine falsche Ausgabe. Das System funktioniert einwandfrei. Das Problem sind die Daten, mit denen es arbeitet.
Deshalb ist die Überprüfung der Datenintegrität keine Sicherheitsfunktion, die KI-Systemen nachträglich aufgesetzt wird - sie ist die Voraussetzung für KI-Systeme, auf die sich Organisationen tatsächlich verlassen können.
Warum Modell-Updates kein Datenproblem lösen können
Die KI-Branche gibt Milliarden für Verbesserungen an Modellen aus: größere Kontextfenster, bessere Reasoning-Architekturen, robusteres Fine-Tuning. Diese Fortschritte sind wichtig. Aber sie können das Problem der Datenherkunft nicht lösen.
Ein leistungsfähigeres Modell, das nicht verifizierte Daten abruft, wird nicht weniger, sondern überzeugendere Halluzinationen hervorbringen. Dieselbe Selbstsicherheit, die große Modelle nützlich macht, ist die Eigenschaft, die ihre Fehler gefährlich macht.
Die Lösung muss bei der Datenschicht ansetzen. Konkret:
Kryptografisches Fingerprinting - jedes Dokument, jeder Datensatz und jedes Daten-Asset, das in eine KI-Pipeline gelangt, sollte einen manipulationserkennbaren Hash haben, der in einem unabhängigen Ledger verankert ist. Jede Änderung - ob absichtlich oder versehentlich - ist sofort erkennbar.
Nachverfolgung der Herkunft - das KI-System sollte für jedes Datenelement, das es verwendet, die Frage beantworten können: 'Woher stammt das, und hat es sich seit der Aufnahme verändert?'
Kontinuierliche Integritätsüberwachung - statische Prüfungen bei der Aufnahme reichen nicht aus. Daten in Retrieval-Speichern müssen kontinuierlich überwacht werden, nicht nur im Moment des Hochladens.
Die verifizierbare Vertrauensinfrastruktur von ROOTKey bietet genau dieses Fundament - und ermöglicht es Unternehmen, KI-Systeme auf Daten aufzubauen, denen sie tatsächlich vertrauen können. Starten Sie mit einem kostenlosen Konto und verankern Sie Ihr erstes Daten-Asset in weniger als fünf Minuten.
- Prüfen Sie jede Datenquelle, die Ihre KI-Systeme speist - wann wurde sie zuletzt verifiziert? Können Sie erkennen, wenn sie sich ändert?
- Implementieren Sie bei RAG-Systemen kryptografisches Hashing bei der Aufnahme und verifizieren Sie erneut zum Zeitpunkt des Abrufs.
- Behandeln Sie Datenherkunft als Compliance-Anforderung, nicht als bloßes technisches Extra.
- Lesen Sie unsere ausführlichere Analyse dazu, warum Datenintegrität durch Technikgestaltung vom ersten Tag an der richtige Architekturansatz ist.