التشخيص الخاطئ يكلّف المؤسسات الملايين
في كل أسبوع، يُسحب نشرٌ مؤسسي آخر للذكاء الاصطناعي إثر حادثة هلوسة. يتلقى فريق قانوني ملخصًا لعقد يتضمن بنودًا مختلَقة. وتحصل إدارة مالية على تقرير مخاطر يتضمن استشهادات تنظيمية مُلفَّقة. ويكتشف مسؤول امتثال أن مساعده القائم على الذكاء الاصطناعي استشهد بلائحة تنظيمية لا وجود لها.
الميل الغريزي هو إلقاء اللوم على النموذج. تحديث الأوزان. تغيير المزوّد. إضافة مزيد من الضوابط الوقائية. لكن النموذج في معظم الحالات ليس هو المشكلة. المشكلة في البيانات.
الهلوسة - أي مخرجات الذكاء الاصطناعي التي تُقدَّم بثقة وتبدو معقولة لكنها خاطئة من حيث الوقائع - هي في الغالب إخفاقٌ في إثبات مصدر البيانات. وفهم هذا التمييز ليس مسألة نظرية فحسب. فهو يحدد أين ينبغي للمؤسسات أن تستثمر لبناء أنظمة ذكاء اصطناعي جديرة بالثقة فعلًا.
ما هي الهلوسة فعلًا
الهلوسة هي ما يحدث عندما يولّد نموذج ذكاء اصطناعي مخرجات لا تستند إلى حقائق يمكن التحقق منها. والتفسير المعتاد هو أن النموذج «يُكمل أنماطًا» دون فهم. وهذا صحيح لكنه ناقص.
أما التفسير الأكثر فائدة فهو التالي: لا يمكن أن يكون النموذج أدقّ من البيانات التي دُرِّب عليها، ولا، في الأنظمة المعزَّزة بالاسترجاع، أدقّ من البيانات التي يسترجعها لحظة الاستدلال. فعندما تكون هذه البيانات:
- قديمة - تغيّرت اللوائح التنظيمية ولا يزال النموذج يستشهد بالنسخة القديمة
- متلاعبًا بها - عُدِّل مصدر بيانات في مرحلة سابقة دون أن يُكتشف ذلك
- غير متسقة - تتناقض مستندات مختلفة فيما بينها فيأخذ النموذج متوسطها
- مجهولة المصدر - لا يستطيع النموذج التمييز بين المصادر الموثوقة والمصادر منخفضة الجودة
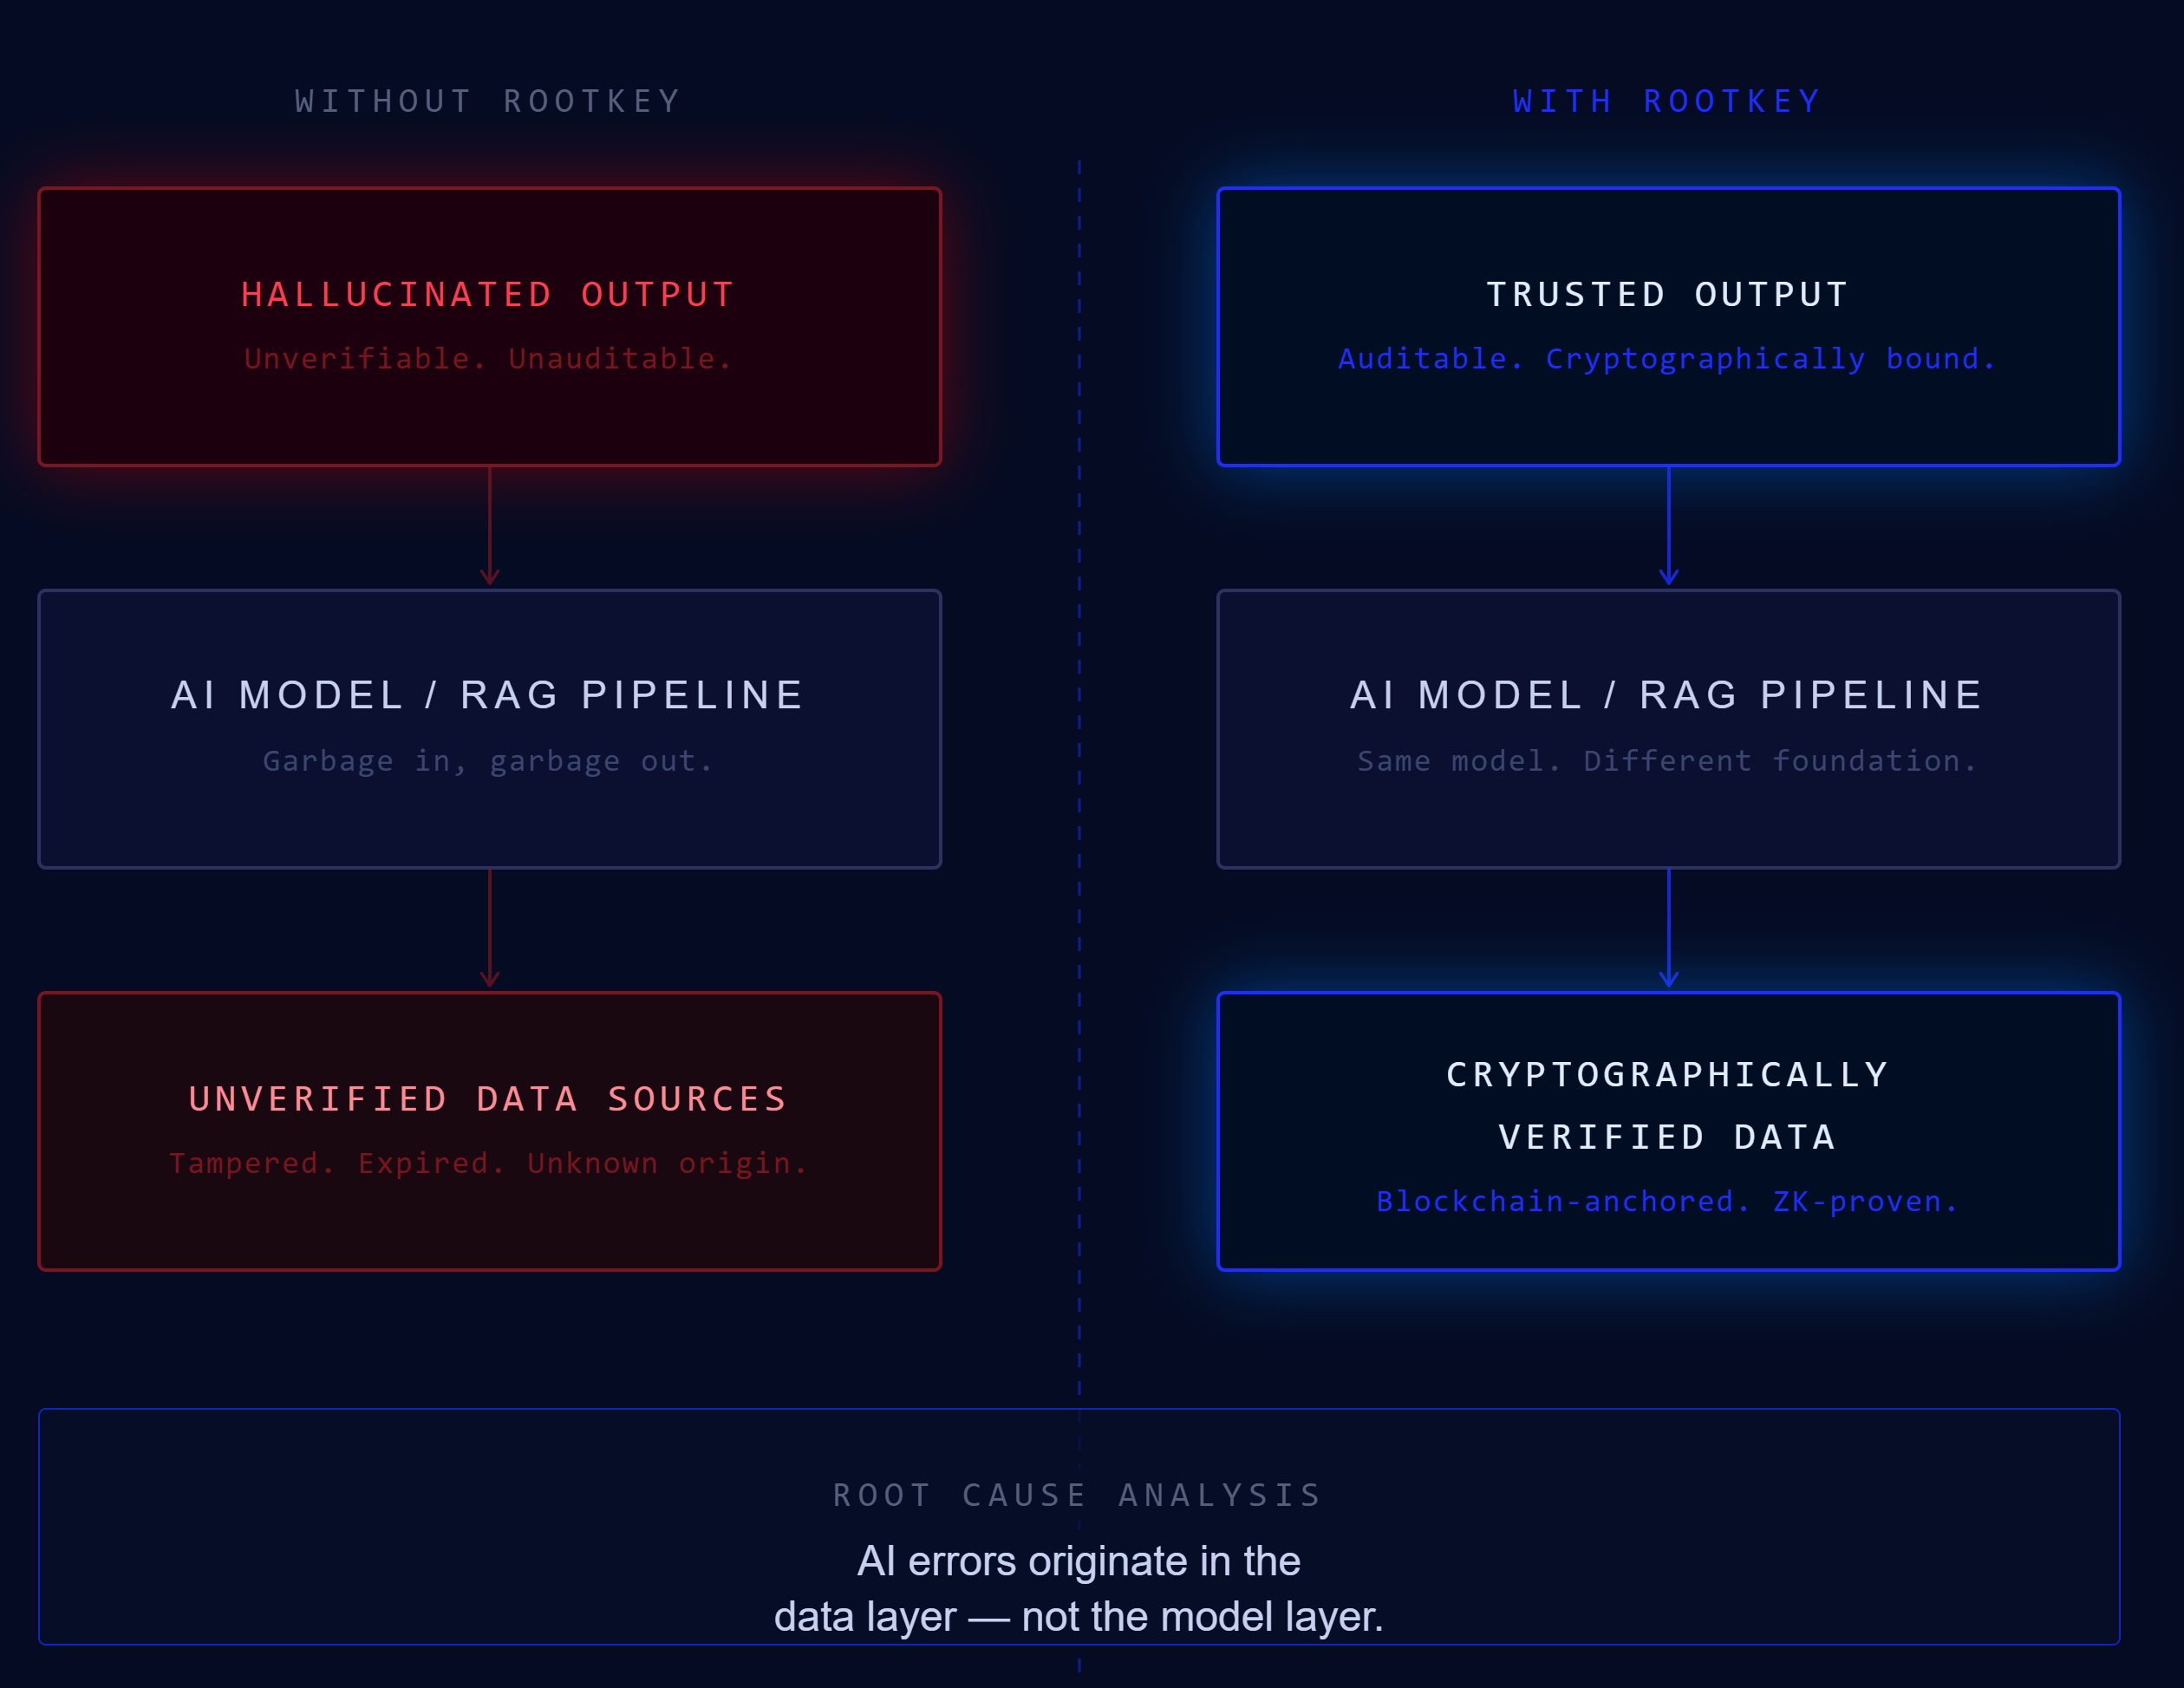
...تكون النتيجة هراءً يُقدَّم بثقة. فالنموذج يفعل بالضبط ما بُني لأجله - توليد نص متماسك ومناسب للسياق. أما الخلل فيكمن في مرحلة سابقة، في طبقة البيانات.
مشكلة الاسترجاع في أنظمة RAG
كان من المفترض أن تحل أنظمة التوليد المعزَّز بالاسترجاع (Retrieval-Augmented Generation، RAG) مشكلة الهلوسة من خلال إسناد مخرجات الذكاء الاصطناعي إلى بيانات تُسترجَع في الوقت الفعلي بدلًا من التدريب الثابت. وهي تساعد فعلًا - عندما تكون البيانات المسترجَعة جديرة بالثقة.
لكن معظم عمليات نشر RAG في المؤسسات تسترجع البيانات من مستودعات المستندات وقواعد المعرفة وقواعد البيانات الداخلية التي تفتقر إلى أي طبقة للتحقق من السلامة. فلا توجد آلية لاكتشاف ما إذا كان مستند مسترجَع قد عُدِّل منذ فهرسته. ولا سبيل لمعرفة ما إذا كانت وثيقة سياسات قد حُدِّثت بهدوء يوم الثلاثاء الماضي، أو ما إذا كان مرجع تنظيمي قد تلف بسبب خطأ في التخزين، أو ما إذا كانت جهة تهديد قد حقنت معلومات زائفة في مجموعة مستندات الاسترجاع.
والنتيجة: يسترجع النموذج بيانات مخترَقة، ويعاملها على أنها موثوقة، ويولّد مخرجات خاطئة بدرجة عالية من الثقة. النظام يعمل على أكمل وجه. المشكلة في البيانات التي يعمل عليها.
لهذا السبب، فإن التحقق من سلامة البيانات ليس ميزة أمنية تُضاف فوق أنظمة الذكاء الاصطناعي - بل هو شرط مسبق لأنظمة ذكاء اصطناعي يمكن للمؤسسات أن تعتمد عليها فعلًا.
لماذا لا تستطيع تحديثات النموذج إصلاح مشكلة في البيانات
ينفق قطاع الذكاء الاصطناعي المليارات على تحسين النماذج: نوافذ سياق أكبر، وبنى استدلال أفضل، وضبط دقيق أكثر متانة. هذه التطورات مهمة. لكنها لا تستطيع حل مشكلة مصدر البيانات.
النموذج الأكثر قدرة الذي يسترجع بيانات غير متحقَّق منها لن يُنتج هلوسات أقل، بل هلوسات أكثر إقناعًا. فالثقة ذاتها التي تجعل النماذج الكبيرة مفيدة هي الخاصية التي تجعل أخطاءها خطيرة.
يجب أن يبدأ الحل من طبقة البيانات. وتحديدًا:
البصمة التشفيرية - ينبغي أن يكون لكل مستند ومجموعة بيانات وأصل بيانات يدخل مسار معالجة الذكاء الاصطناعي قيمة تجزئة (hash) تكشف أي تلاعب، مثبَّتة في سجل مستقل. وأي تعديل - مقصودًا كان أو عرضيًا - يمكن اكتشافه فورًا.
تتبّع المصدر - ينبغي أن يكون نظام الذكاء الاصطناعي قادرًا على الإجابة عن سؤال «من أين أتى هذا، وهل تغيّر منذ إدخاله؟» لكل جزء من البيانات يستخدمه.
المراقبة المستمرة للسلامة - لا تكفي عمليات التحقق الثابتة عند الإدخال. يجب مراقبة البيانات في مستودعات الاسترجاع باستمرار، لا لحظة رفعها فقط.
توفر البنية التحتية للثقة القابلة للتحقق من ROOTKey هذا الأساس تحديدًا - إذ تمكّن المؤسسات من بناء أنظمة ذكاء اصطناعي على بيانات يمكنها الوثوق بها فعلًا. ابدأ بحساب مجاني وثبّت أول أصل من أصول بياناتك في أقل من خمس دقائق.
- دقّق في كل مصدر بيانات يغذّي أنظمة الذكاء الاصطناعي لديك - متى جرى التحقق منه آخر مرة؟ وهل يمكنك اكتشاف تغيّره؟
- في أنظمة RAG، طبّق التجزئة التشفيرية عند الإدخال وأعد التحقق لحظة الاسترجاع.
- تعامل مع إثبات مصدر البيانات بوصفه متطلبًا من متطلبات الامتثال، لا ميزة هندسية تكميلية.
- اقرأ تحليلنا المعمّق حول أسباب كون سلامة البيانات منذ التصميم النهج المعماري الصحيح منذ اليوم الأول.