Introducción
«Datos preparados para la IA» se ha convertido en una de esas expresiones que significan lo que quien las usa necesita que signifiquen. Para un proveedor de plataformas de datos, suele significar esquemas limpios y buena documentación. Para un proveedor de modelos, a menudo significa volumen y diversidad suficientes. Ninguna de las dos definiciones resiste el contacto con un regulador, un auditor o un investigador de incidentes que plantea una pregunta mucho más concreta: ¿puede demostrar, ahora mismo, con qué datos exactamente se entrenó este sistema o con qué datos está operando, y que nada en ellos ha cambiado desde que se aprobó su uso?
La definición convencional no es errónea. Es incompleta.
Unos datos limpios, bien etiquetados y suficientemente representativos importan, sin duda, para la calidad del modelo - el artículo 10 del Reglamento de Inteligencia Artificial de la UE (AI Act) lo dice expresamente. Pero calidad e integridad son propiedades distintas. Un conjunto de datos puede estar perfectamente limpio, equilibrado y bien documentado el día en que se compila y, aun así, ser indefendible seis meses después si no hay forma de demostrar que desde entonces no se ha alterado, complementado ni nutrido discretamente de otras fuentes. La mayoría de las listas de comprobación de «preparación para la IA» se detienen en el momento de la compilación. La auditabilidad empieza ahí y nunca se detiene.
Una definición operativa
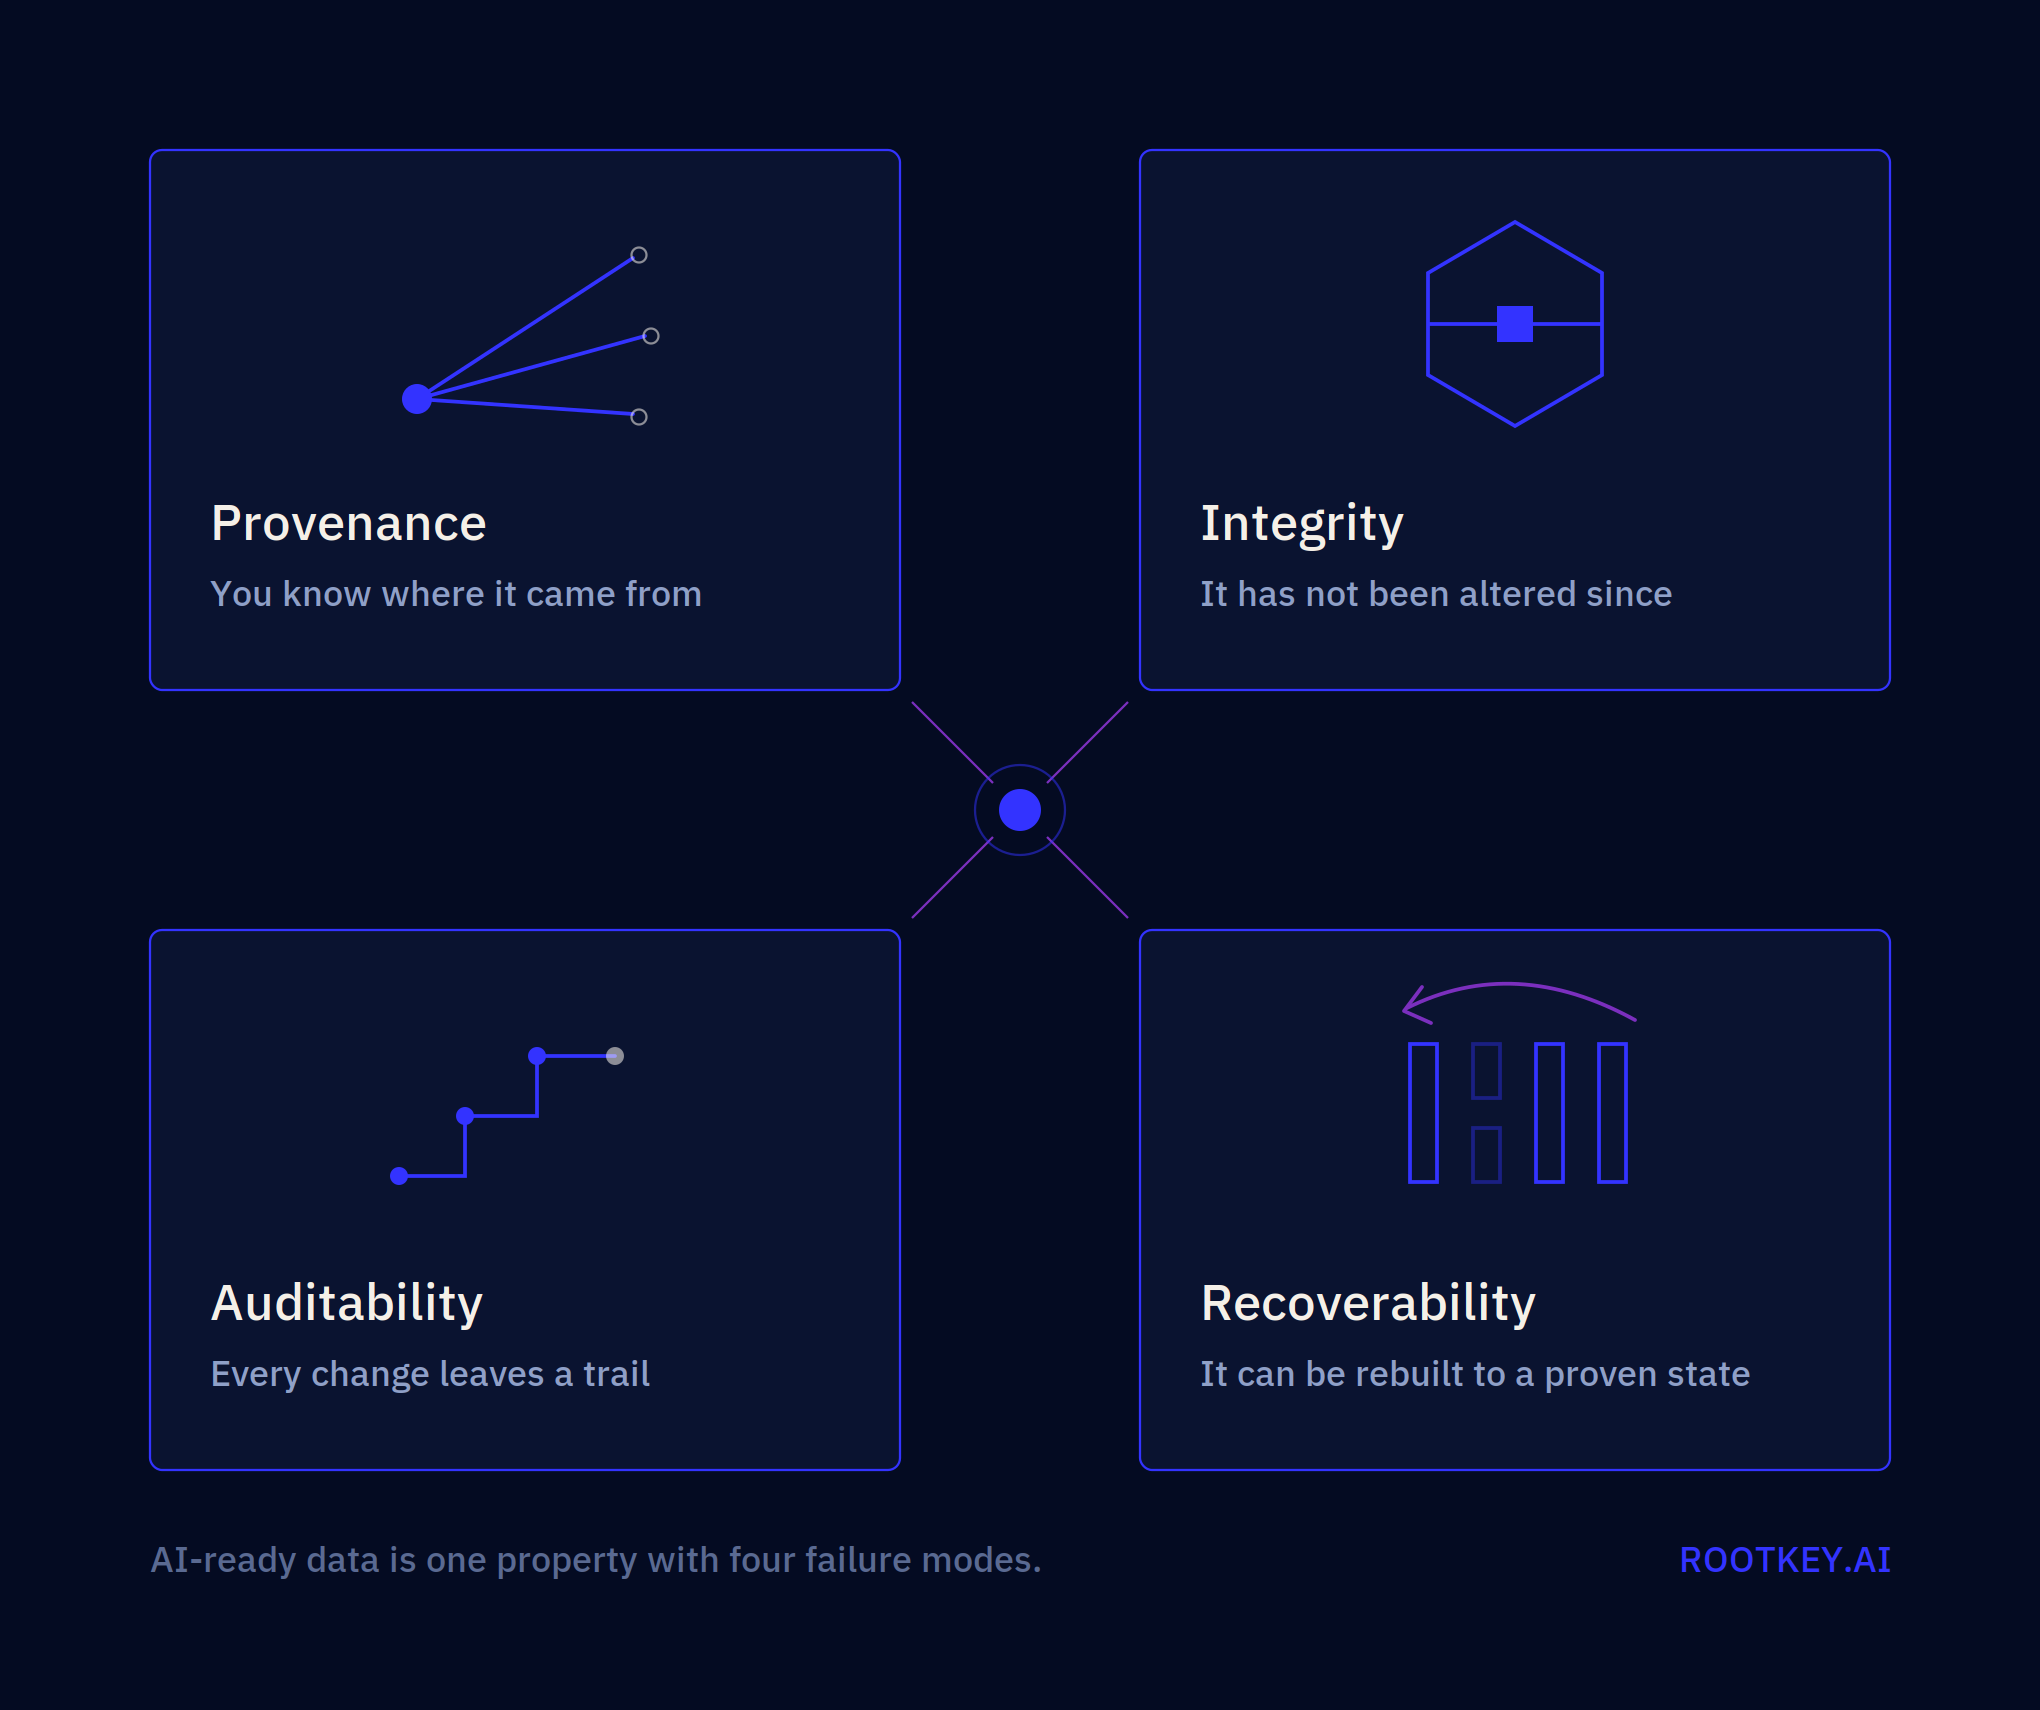
Los datos están preparados para la IA cuando cumplen cuatro propiedades, de forma continua
En primer lugar, procedencia: el origen de cada registro está documentado y es verificable, no simplemente afirmado. En segundo lugar, evidencia de inmutabilidad: cualquier cambio en el conjunto de datos desde su certificación es detectable criptográficamente, no solo registrado en una base de datos que podría, a su vez, ser alterada. En tercer lugar, rendición de cuentas sobre el acceso: cada parte que ha tocado los datos, y cuándo lo hizo, forma parte del registro permanente. En cuarto lugar, reproducibilidad: a partir del estado certificado del conjunto de datos, los datos exactos utilizados para entrenar o ajustar una versión concreta de un modelo pueden reconstruirse a petición, en lugar de aproximarse de memoria o a partir de documentación redactada a posteriori.
Por qué «documentado» y «verificable» no son la misma palabra
Una hoja de cálculo que describe de dónde proceden los datos de entrenamiento es documentación. La redacta la misma parte que tiene interés en que la auditoría se supere, y puede editarse a posteriori sin dejar rastro. La procedencia verificable significa que el registro del origen quedó fijado en el momento de la ingesta, con independencia de la parte auditada, de forma que no pueda revisarse discretamente más tarde sin dejar evidencia de esa revisión. Esa distinción - entre una afirmación y una afirmación que no puede alterarse en silencio - es toda la diferencia entre un relato de cumplimiento y una evidencia de cumplimiento.
- Procedencia: ¿dónde se originó este registro, y puede demostrarse ese origen en lugar de simplemente afirmarse?
- Evidencia de inmutabilidad: si este registro cambiara después de la certificación, ¿sería ese cambio detectable criptográficamente?
- Rendición de cuentas sobre el acceso: ¿existe un registro permanente, en el que cualquier manipulación quede en evidencia, de cada parte que ha tocado estos datos?
- Reproducibilidad: ¿puede reconstruirse a petición el conjunto de datos exacto que hay detrás de cualquier versión concreta de un modelo?
«Preparado para la IA» se está convirtiendo rápidamente en un término de cumplimiento normativo, no solo de calidad de datos. Los datos que no pueden demostrar su propio historial no superarán las auditorías que ya están llegando en virtud del AI Act de la UE, de la Directiva NIS2 y de las normas sectoriales de gobernanza de la IA. Descubra cómo ROOTKey ancla la procedencia y la integridad de los datos de forma continua, no solo en el momento de la recopilación.