El diagnóstico equivocado está costando millones a las empresas
Cada semana, otro despliegue empresarial de IA se retira tras un incidente de alucinación. Un equipo jurídico recibe un resumen de contrato con cláusulas inventadas. Un departamento financiero recibe un informe de riesgos con citas normativas ficticias. Un responsable de cumplimiento descubre que su asistente de IA ha citado una normativa que no existe.
El instinto es culpar al modelo. Actualizar los pesos. Cambiar de proveedor. Añadir más salvaguardas. Pero, en la mayoría de los casos, el problema no es el modelo. Son los datos.
Las alucinaciones - resultados de IA que se presentan con total seguridad y parecen verosímiles, pero que son objetivamente erróneos - son, predominantemente, un fallo de procedencia de los datos. Entender esta distinción no es una cuestión meramente académica. Determina dónde deben invertir las organizaciones para crear sistemas de IA que sean realmente fiables.
Qué son realmente las alucinaciones
Una alucinación es lo que ocurre cuando un modelo de IA genera un resultado que no se basa en hechos verificables. La explicación habitual es que el modelo está 'completando patrones' sin comprender. Es correcta, pero incompleta.
La explicación más útil es esta: un modelo solo puede ser tan preciso como los datos con los que se entrenó y, en los sistemas aumentados por recuperación, los datos que recupera en el momento de la inferencia. Cuando esos datos están:
- Desactualizados - la normativa ha cambiado y el modelo sigue citando la versión antigua
- Manipulados - una fuente de datos situada aguas arriba se modificó sin que se detectara
- Incoherentes - distintos documentos se contradicen y el modelo hace una media entre ellos
- Sin atribución - el modelo no puede distinguir las fuentes fidedignas de las de baja calidad
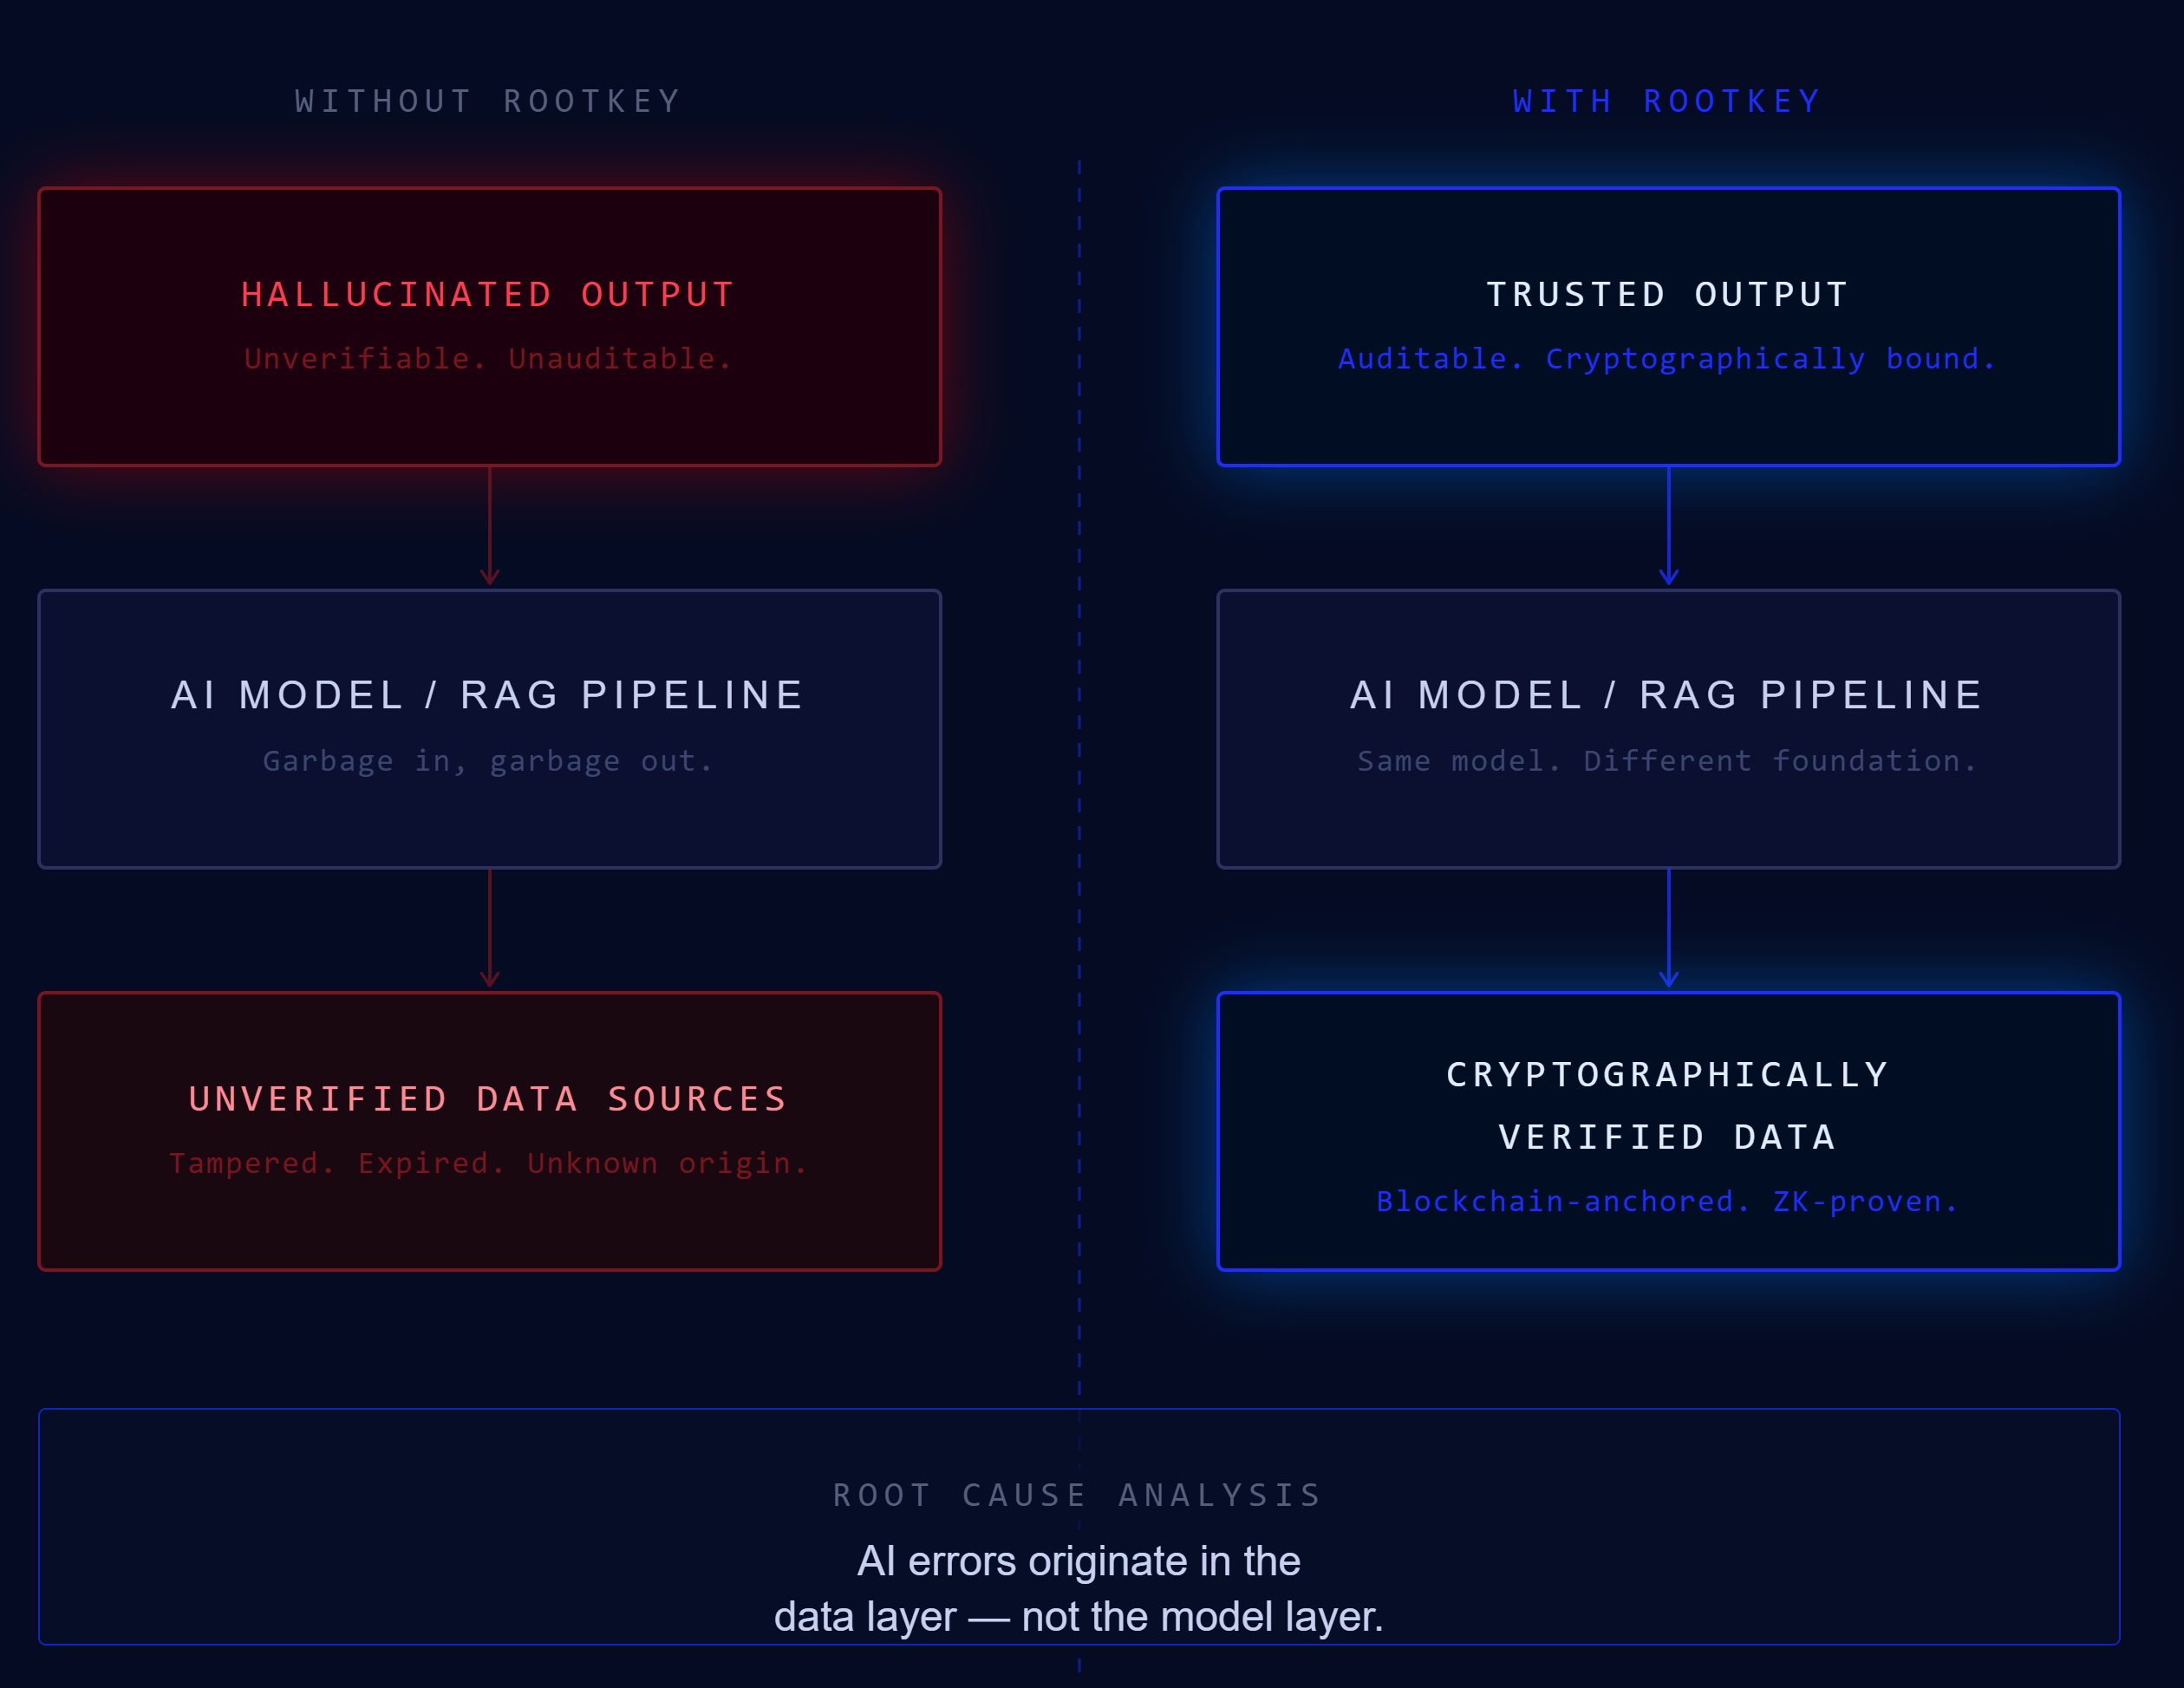
...el resultado son disparates dichos con total seguridad. El modelo hace exactamente aquello para lo que se diseñó - generar texto coherente y adecuado al contexto. El fallo está aguas arriba, en la capa de datos.
El problema de la recuperación en los sistemas RAG
Los sistemas de generación aumentada por recuperación (Retrieval-Augmented Generation, RAG) debían resolver el problema de las alucinaciones fundamentando los resultados de la IA en la recuperación de datos en tiempo real en lugar de en un entrenamiento estático. Y ayudan - cuando los datos recuperados son fiables.
Pero la mayoría de los despliegues empresariales de RAG recuperan información de repositorios de documentos, bases de conocimiento y bases de datos internas que carecen de una capa de verificación de integridad. No existe ningún mecanismo para detectar si un documento recuperado se ha modificado desde que se indexó. No hay forma de saber si un documento de políticas se actualizó discretamente el martes pasado, si una referencia normativa se corrompió por un error de almacenamiento o si un actor de amenazas inyectó información falsa en el corpus de recuperación.
El resultado: el modelo recupera datos comprometidos, los trata como fidedignos y genera un resultado erróneo con un alto grado de confianza. El sistema funciona a la perfección. El problema son los datos con los que trabaja.
Por eso la verificación de la integridad de los datos no es una función de seguridad añadida sobre los sistemas de IA - es un requisito previo para tener sistemas de IA en los que las organizaciones puedan confiar de verdad.
Por qué actualizar el modelo no puede resolver un problema de datos
El sector de la IA invierte miles de millones en mejorar los modelos: ventanas de contexto más amplias, mejores arquitecturas de razonamiento, un ajuste fino más robusto. Estos avances importan. Pero no pueden resolver el problema de la procedencia de los datos.
Un modelo más capaz que recupera datos no verificados no producirá menos alucinaciones, sino alucinaciones más convincentes. La misma seguridad que hace útiles a los grandes modelos es la propiedad que hace peligrosos sus errores.
La solución tiene que empezar en la capa de datos. En concreto:
Huella digital criptográfica - cada documento, conjunto de datos y activo de datos que entra en un pipeline de IA debe tener un hash con detección de manipulaciones, anclado en un registro independiente. Cualquier modificación - intencionada o accidental - se puede detectar de inmediato.
Seguimiento de la procedencia - el sistema de IA debe poder responder a '¿de dónde procede esto y ha cambiado desde que se ingirió?' para cada dato que utiliza.
Supervisión continua de la integridad - las comprobaciones estáticas en la ingesta no bastan. Los datos de los repositorios de recuperación deben supervisarse de forma continua, no solo en el momento de la carga.
La infraestructura de confianza verificable de ROOTKey proporciona exactamente esta base - permite a las empresas construir sistemas de IA sobre datos en los que pueden confiar de verdad. Empiece con una cuenta gratuita y ancle su primer activo de datos en menos de cinco minutos.
- Audite todas las fuentes de datos que alimentan sus sistemas de IA - ¿cuándo se verificaron por última vez? ¿Puede detectar si cambian?
- En los sistemas RAG, implemente hashing criptográfico en la ingesta y vuelva a verificar en el momento de la recuperación.
- Trate la procedencia de los datos como un requisito de cumplimiento, no como un extra de ingeniería.
- Lea nuestro análisis en profundidad sobre por qué la integridad de los datos desde el diseño es el enfoque arquitectónico correcto desde el primer día.