引言
大多数在受监管决策(信用评分、招聘筛选、保险核保、欺诈标记)中部署 AI 的组织,都已经在记录某些内容:时间戳、输入、输出,或许还有模型版本号。当监管机构或受影响的个人在数月后对该决策提出质疑时,这样的日志很少足够。真正被问到的问题不是“模型输出了什么”,而是“您能否证明,做出这项决策的模型在做出判断的那一刻,所处理的正是它本应处理的数据,并且这些数据未经改动”。现有的大多数日志基础设施从一开始就不是为回答这个问题而构建的。
符合监管要求的审计追踪究竟需要什么
决策、模型版本与数据必须永久关联
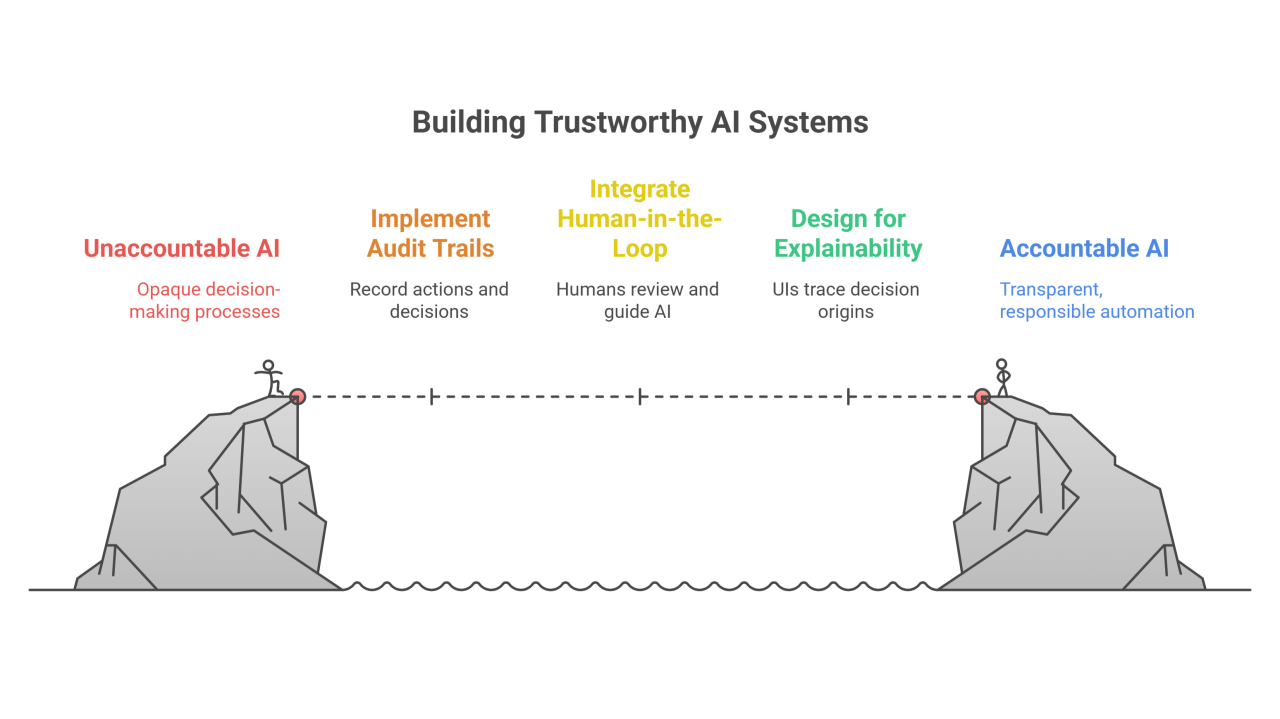
一条站得住脚的审计追踪,会在决策发生的那一刻把三样东西关联起来:具体的输入和输出;产生该结果的确切模型版本(而不是像“production”这样随时间推移悄然指向不同权重的滚动标签);以及模型所依赖的任何参考数据或训练数据的具体状态。只要这三者中任何一项能在历史记录中独立于其他两项发生变化,链条就会断裂,受到质疑的决策也就无法被可靠地重建。
记录必须做到篡改可察觉,而不只是支持仅追加写入
仅追加(append-only)日志是一个良好的基础,但它本身并不能证明没有任何内容被修改,它只是让随意修改变得更困难。符合监管要求的审计追踪要求:对历史记录的任何修改,无论以何种方式发生,都能通过密码学手段被检测出来。这正是两种日志的区别:一种是工程师因为亲手搭建而信任的日志,另一种是外部审计师无需听信组织一面之词、即可独立验证的日志。
保留期限必须覆盖质疑期限,而非模型生命周期
模型版本会按照工程时间表被弃用和下线。而监管和法律上的质疑期限并不遵循这一时间表:一项招聘决定或一次信贷拒绝,可能在做出该决定的模型被替换很久之后仍遭到质疑。如果审计追踪架构将记录的保留期限与模型生命周期挂钩,而不是与适用的法律质疑期限挂钩,那么恰恰会在最关键的地方出现缺口。
与数据溯源的关联,不止于日志记录
一条审计追踪如果能忠实记录决策,却无法独立验证其背后数据的完整性,那就只解决了一半的问题。如果训练数据或参考数据本身可能在未被察觉的情况下遭到改动,那么即使决策追踪记录得再完美,也是建立在无法验证的基础之上。决策记录与数据完整性这两个问题必须一并解决,并锚定到同一个密码学根上;否则,审计追踪最有力的主张就会沦为“我们没有发现任何异常”,而这并不等同于证明。
- 将每条决策记录绑定到特定且不可变的模型版本,绝不使用滚动标签
- 将参考数据和训练数据的状态与决策一同锚定,而不是放在一个独立、割裂的系统中
- 让对历史记录的任何修改都能通过密码学手段被检测出来,而不只是做到仅追加写入
- 根据适用的法律质疑期限设定保留期限,而不是依据模型的部署生命周期
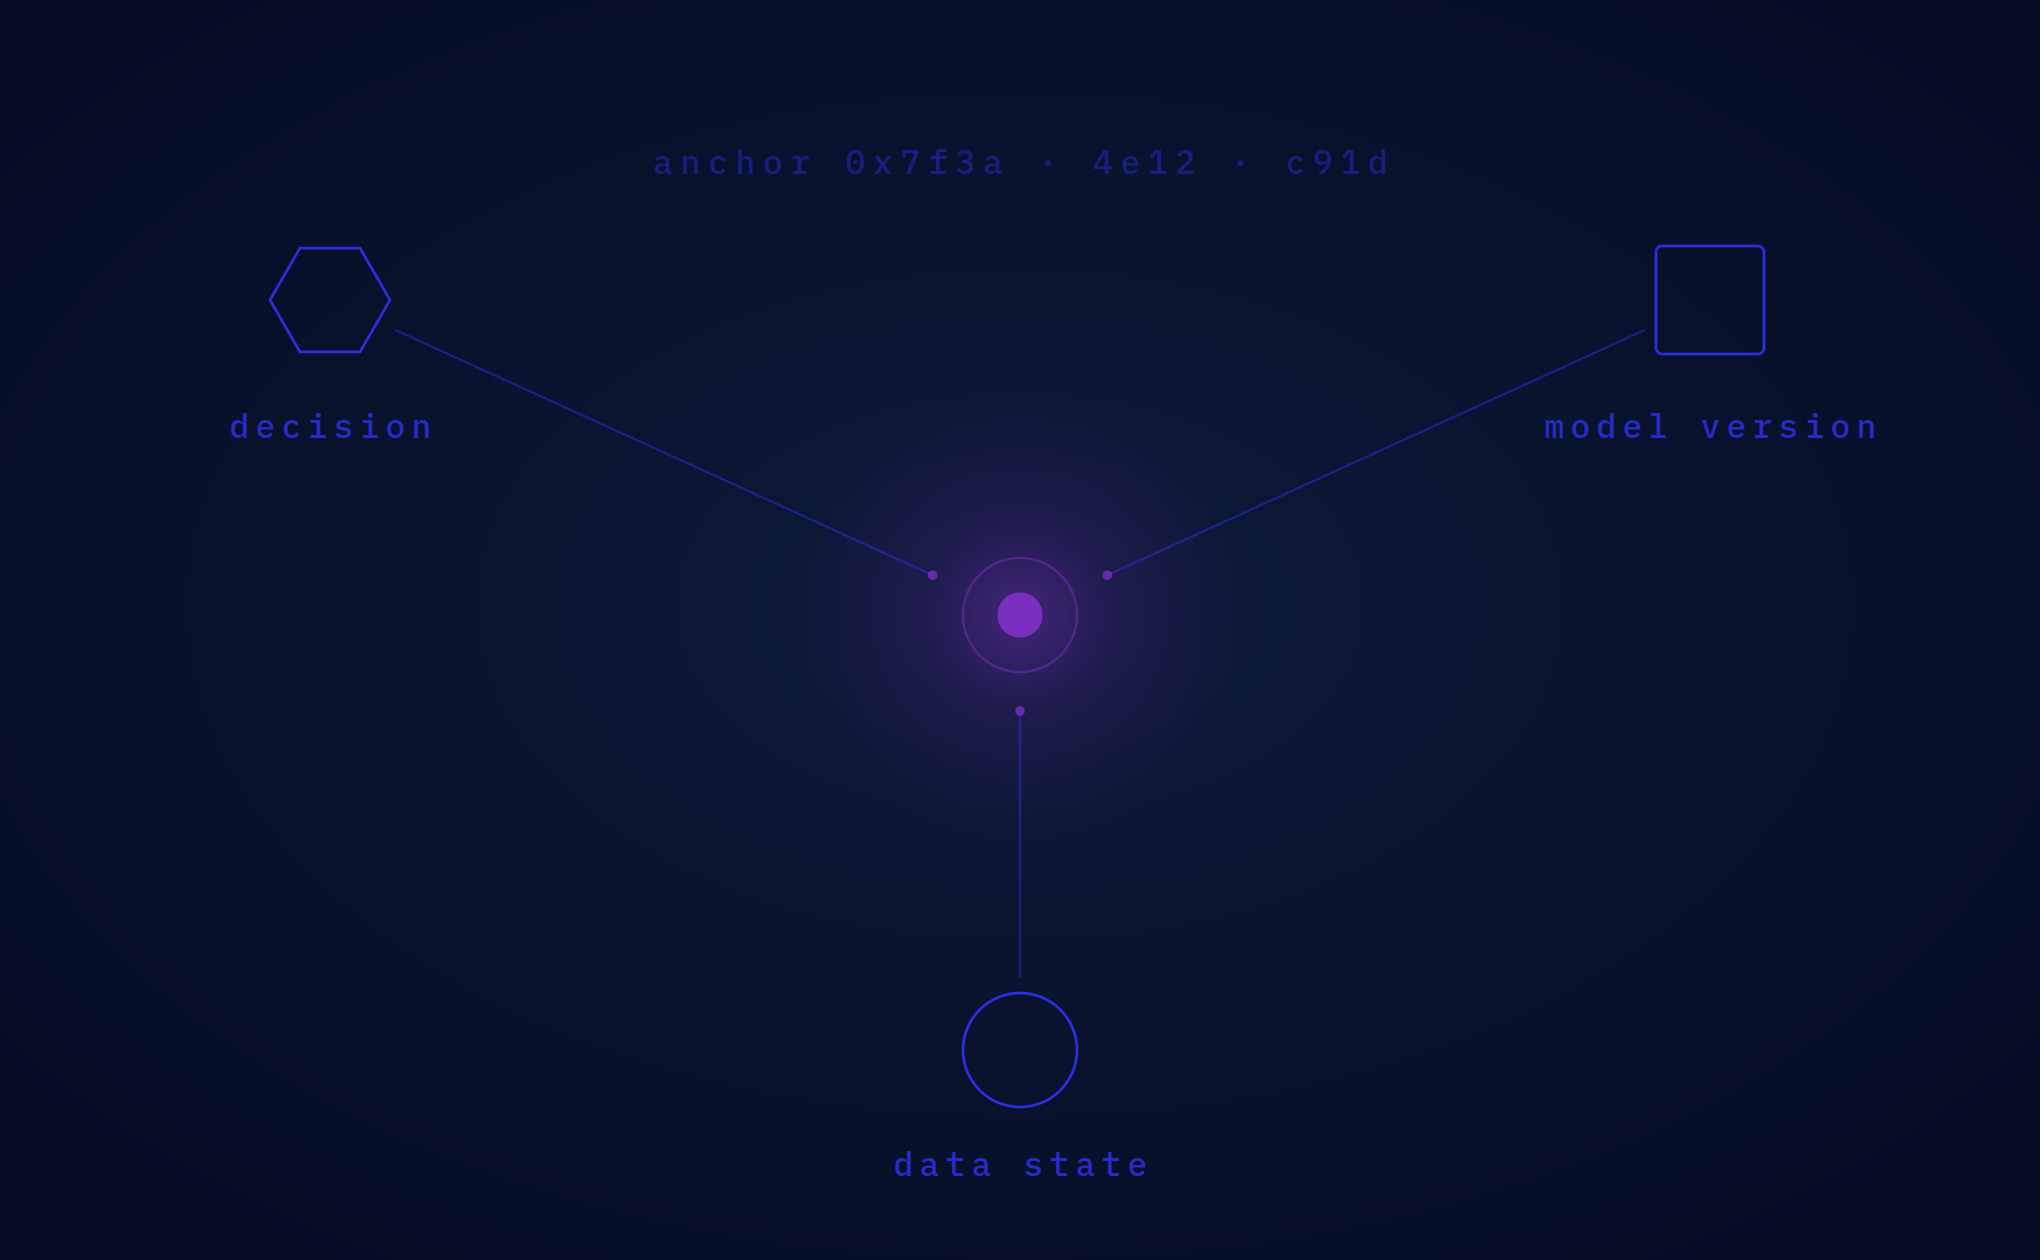
一份无法独立证明其背后数据完整性的决策日志,算不上审计追踪,只是一种声明。了解 ROOTKey 如何将决策、模型版本和数据状态锚定到单一、可验证的记录中。