Un mauvais diagnostic qui coûte des millions aux entreprises
Chaque semaine, un nouveau déploiement d’IA en entreprise est retiré à la suite d’un incident d’hallucination. Une équipe juridique reçoit une synthèse de contrat comportant des clauses inventées. Une direction financière reçoit un rapport de risques contenant des références réglementaires fictives. Un responsable de la conformité découvre que son assistant d’IA a cité une réglementation qui n’existe pas.
Le réflexe est d’accuser le modèle. Mettre à jour les poids. Changer de fournisseur. Ajouter davantage de garde-fous. Mais, dans la plupart des cas, le problème n’est pas le modèle. Ce sont les données.
Les hallucinations - des sorties d’IA formulées avec assurance, d’apparence plausible, mais factuellement fausses - relèvent principalement d’une défaillance de la provenance des données. Comprendre cette distinction n’a rien de purement théorique. C’est ce qui détermine où les organisations doivent investir pour construire des systèmes d’IA réellement dignes de confiance.
Ce que sont réellement les hallucinations
Une hallucination se produit lorsqu’un modèle d’IA génère une sortie qui ne repose pas sur des faits vérifiables. L’explication habituelle veut que le modèle « complète des schémas » sans comprendre. C’est exact, mais incomplet.
L’explication la plus utile est la suivante : un modèle ne peut être plus exact que les données sur lesquelles il a été entraîné et, dans les systèmes augmentés par récupération, que les données qu’il récupère au moment de l’inférence. Lorsque ces données sont :
- Obsolètes - la réglementation a changé, le modèle cite toujours l’ancienne version
- Altérées - une source de données en amont a été modifiée sans que cela soit détecté
- Incohérentes - des documents différents se contredisent et le modèle en fait la moyenne
- Non attribuées - le modèle ne peut pas distinguer les sources faisant autorité des sources de faible qualité
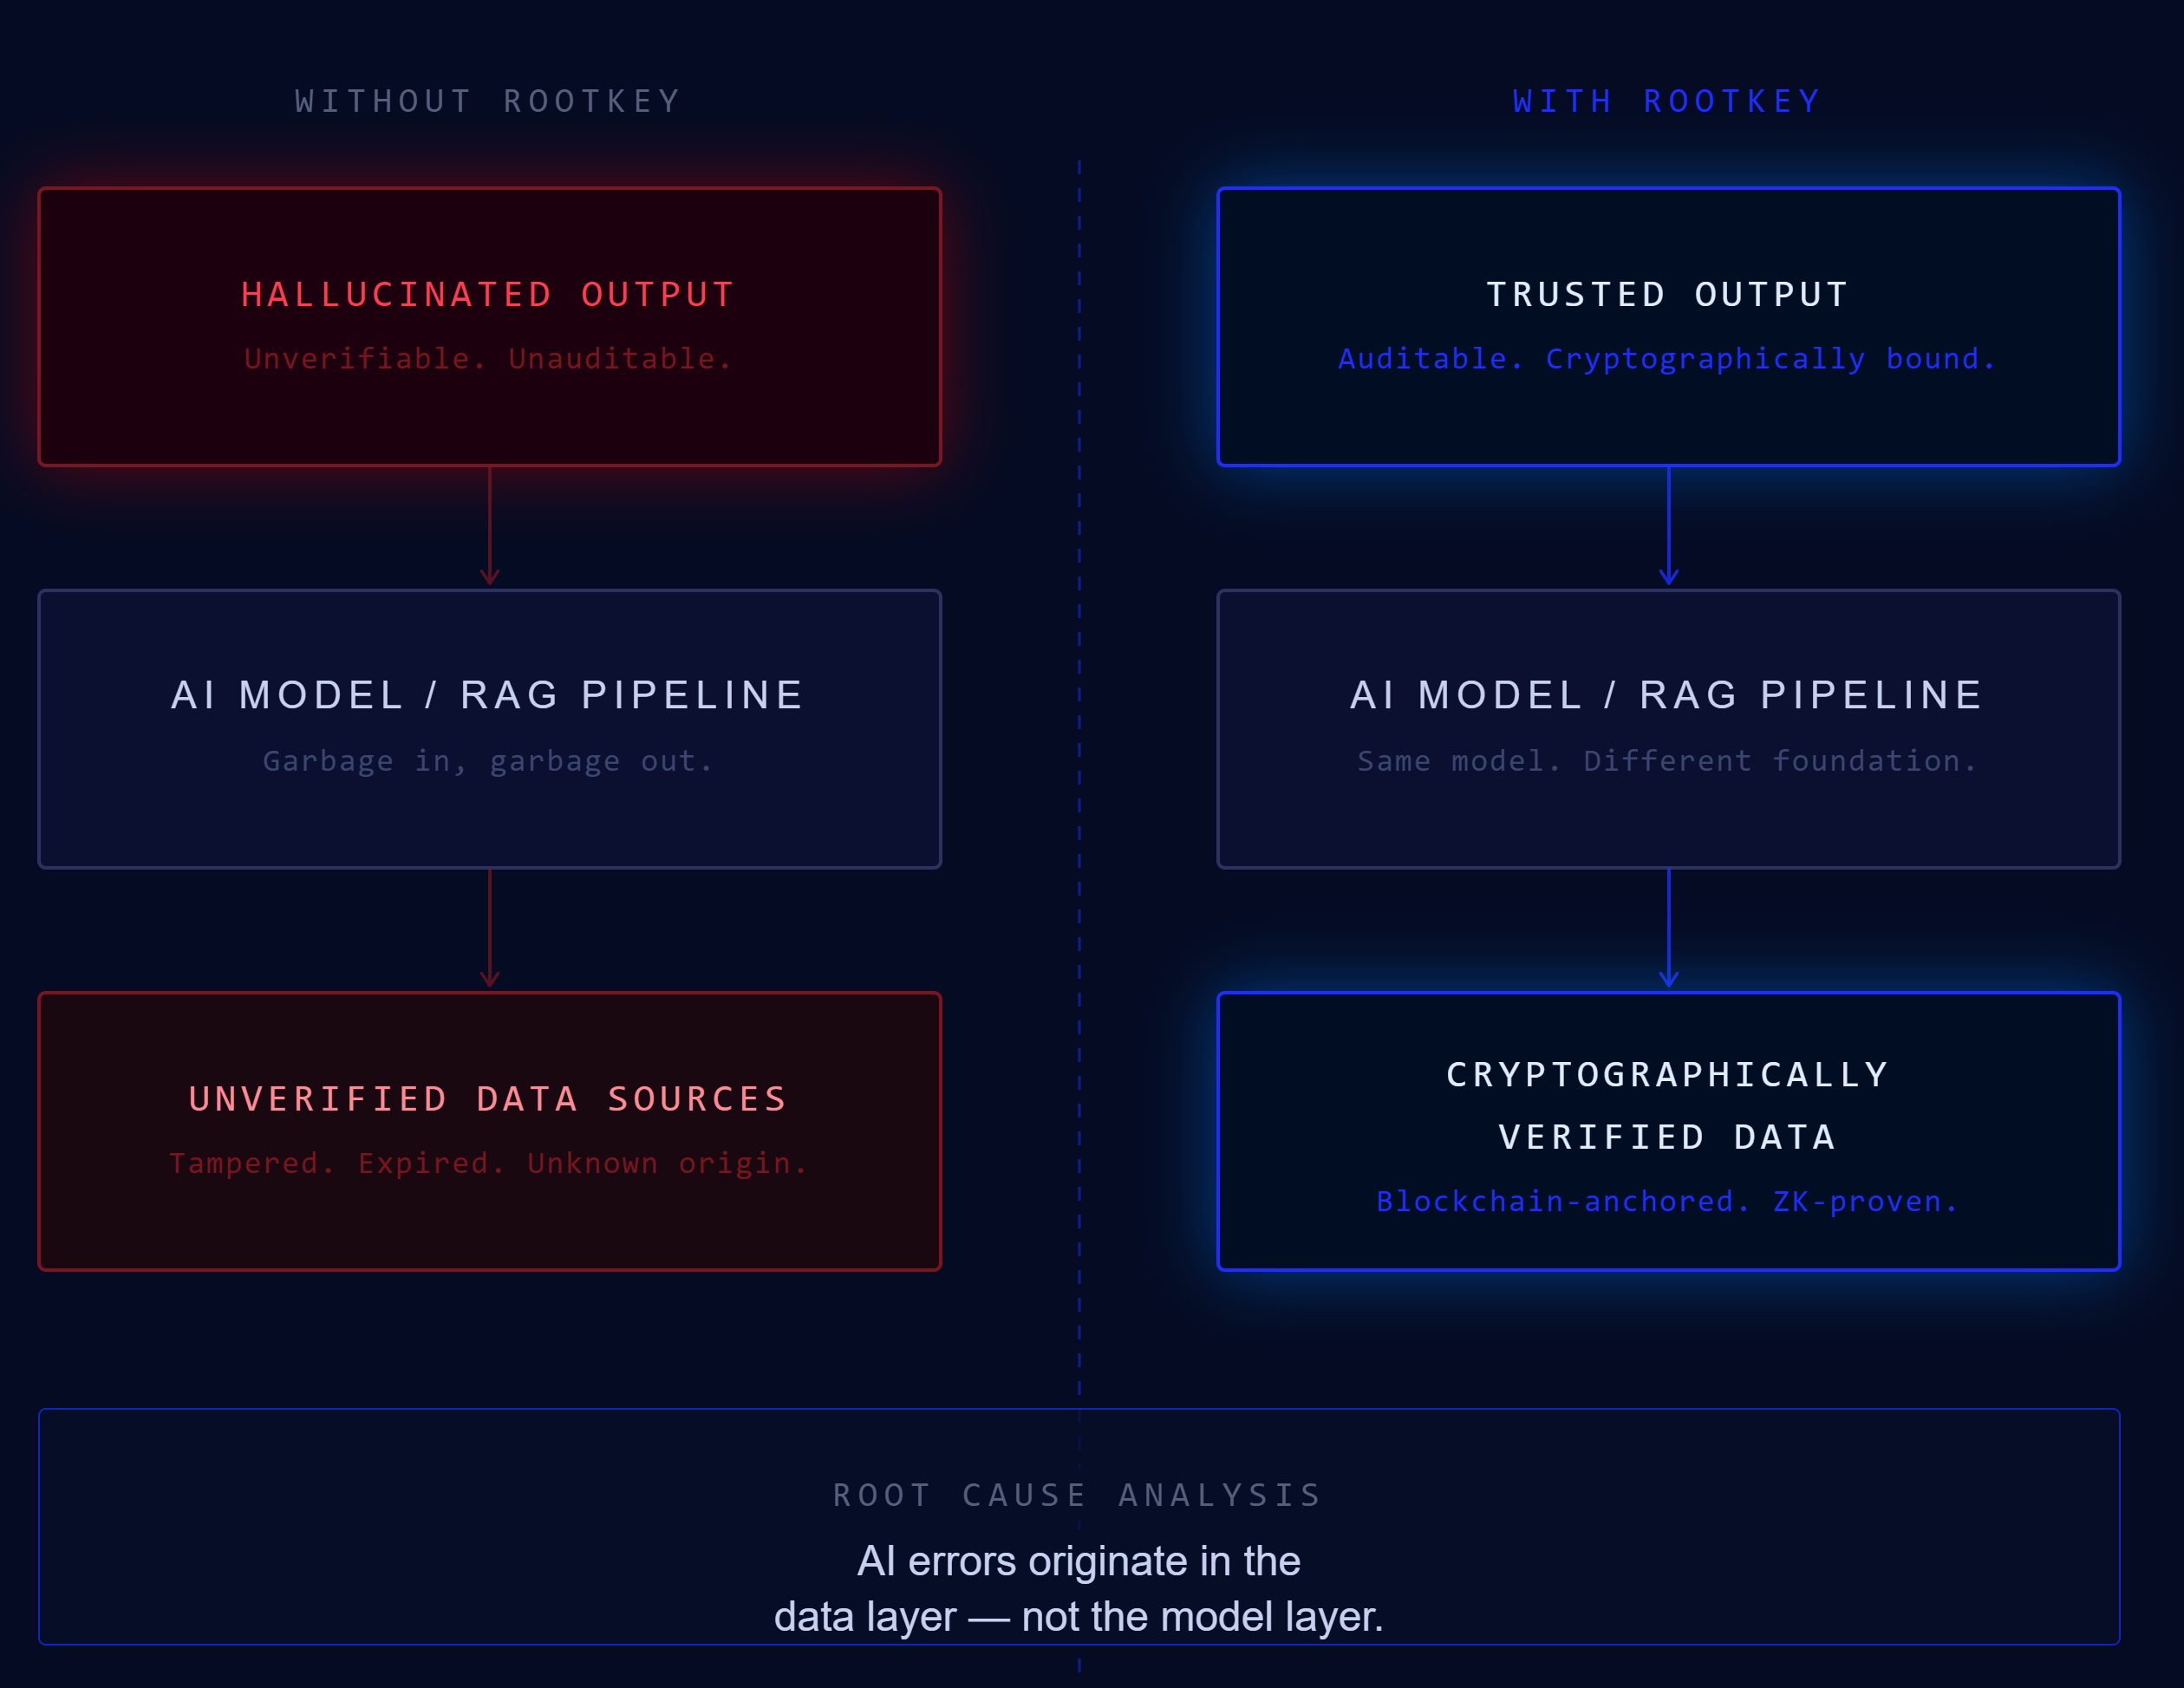
...le résultat est un non-sens énoncé avec assurance. Le modèle fait exactement ce pour quoi il a été conçu - générer un texte cohérent et adapté au contexte. La faute se situe en amont, dans la couche de données.
Le problème de la récupération dans les systèmes RAG
Les systèmes de génération augmentée par récupération (Retrieval-Augmented Generation, RAG) devaient résoudre le problème des hallucinations en ancrant les sorties de l’IA dans une récupération de données en temps réel plutôt que dans un entraînement statique. Et ils y contribuent - lorsque les données récupérées sont fiables.
Mais la plupart des déploiements RAG en entreprise puisent dans des référentiels documentaires, des bases de connaissances et des bases de données internes dépourvus de toute couche de vérification d’intégrité. Aucun mécanisme ne permet de détecter si un document récupéré a été modifié depuis son indexation. Impossible de savoir si un document de politique interne a été discrètement mis à jour mardi dernier, si une référence réglementaire a été corrompue par une erreur de stockage, ou si un acteur malveillant a injecté de fausses informations dans le corpus de récupération.
Résultat : le modèle récupère des données compromises, les traite comme faisant autorité et génère une sortie erronée avec un haut degré de confiance. Le système fonctionne parfaitement. Le problème, ce sont les données avec lesquelles il travaille.
C’est pourquoi la vérification de l’intégrité des données n’est pas une fonctionnalité de sécurité ajoutée par-dessus les systèmes d’IA - c’est un prérequis pour des systèmes d’IA sur lesquels les organisations peuvent réellement s’appuyer.
Pourquoi mettre à jour le modèle ne peut pas résoudre un problème de données
Le secteur de l’IA dépense des milliards pour améliorer les modèles : fenêtres de contexte plus larges, meilleures architectures de raisonnement, ajustement fin plus robuste. Ces avancées comptent. Mais elles ne peuvent pas résoudre le problème de la provenance des données.
Un modèle plus performant qui récupère des données non vérifiées produira des hallucinations plus convaincantes, et non moins nombreuses. L’assurance même qui rend les grands modèles utiles est la propriété qui rend leurs erreurs dangereuses.
La solution doit commencer au niveau de la couche de données. Concrètement :
Empreinte cryptographique - chaque document, jeu de données et actif de données qui entre dans un pipeline d’IA doit disposer d’un hash révélant toute altération, ancré dans un registre indépendant. Toute modification - intentionnelle ou accidentelle - est immédiatement détectable.
Traçabilité de la provenance - le système d’IA doit pouvoir répondre à la question « d’où cela vient-il et cela a-t-il changé depuis son ingestion ? » pour chaque donnée qu’il utilise.
Surveillance continue de l’intégrité - les contrôles statiques à l’ingestion ne suffisent pas. Les données des référentiels de récupération doivent être surveillées en continu, et pas seulement au moment de leur chargement.
L’infrastructure de confiance vérifiable de ROOTKey fournit précisément ce socle - elle permet aux entreprises de construire des systèmes d’IA sur des données auxquelles elles peuvent réellement se fier. Commencez avec un compte gratuit et ancrez votre premier actif de données en moins de cinq minutes.
- Auditez chaque source de données qui alimente vos systèmes d’IA - quand a-t-elle été vérifiée pour la dernière fois ? Pouvez-vous détecter si elle change ?
- Pour les systèmes RAG, mettez en œuvre un hachage cryptographique à l’ingestion et revérifiez au moment de la récupération.
- Traitez la provenance des données comme une exigence de conformité, et non comme un simple confort d’ingénierie.
- Lisez notre analyse approfondie expliquant pourquoi l’intégrité des données dès la conception est la bonne approche architecturale dès le premier jour.