O diagnóstico errado está a custar milhões às empresas
Todas as semanas, mais uma implementação empresarial de IA é retirada após um incidente de alucinação. Uma equipa jurídica recebe um resumo de contrato com cláusulas inventadas. Um departamento financeiro recebe um relatório de risco com citações regulamentares fabricadas. Um responsável de conformidade descobre que o seu assistente de IA citou um regulamento que não existe.
O instinto é culpar o modelo. Atualizar os pesos. Mudar de fornecedor. Acrescentar mais salvaguardas. Mas, na maioria dos casos, o problema não é o modelo. São os dados.
As alucinações - resultados de IA apresentados com confiança e de aparência plausível, mas factualmente errados - são, predominantemente, uma falha de proveniência dos dados. Compreender esta distinção não é uma questão meramente académica. Determina onde as organizações devem investir para construir sistemas de IA que sejam, de facto, fiáveis.
O que são, afinal, as alucinações
Uma alucinação é o que acontece quando um modelo de IA gera um resultado que não assenta em factos verificáveis. A explicação habitual é que o modelo está a 'completar padrões' sem compreender. Isto é exato, mas incompleto.
A explicação mais útil é esta: um modelo só pode ser tão exato quanto os dados com que foi treinado e, nos sistemas aumentados por recuperação, os dados que recupera no momento da inferência. Quando esses dados estão:
- Desatualizados - a regulamentação mudou e o modelo continua a citar a versão antiga
- Adulterados - uma fonte de dados a montante foi modificada sem que isso fosse detetado
- Inconsistentes - diferentes documentos contradizem-se e o modelo faz a média entre eles
- Sem atribuição - o modelo não consegue distinguir as fontes fidedignas das fontes de baixa qualidade
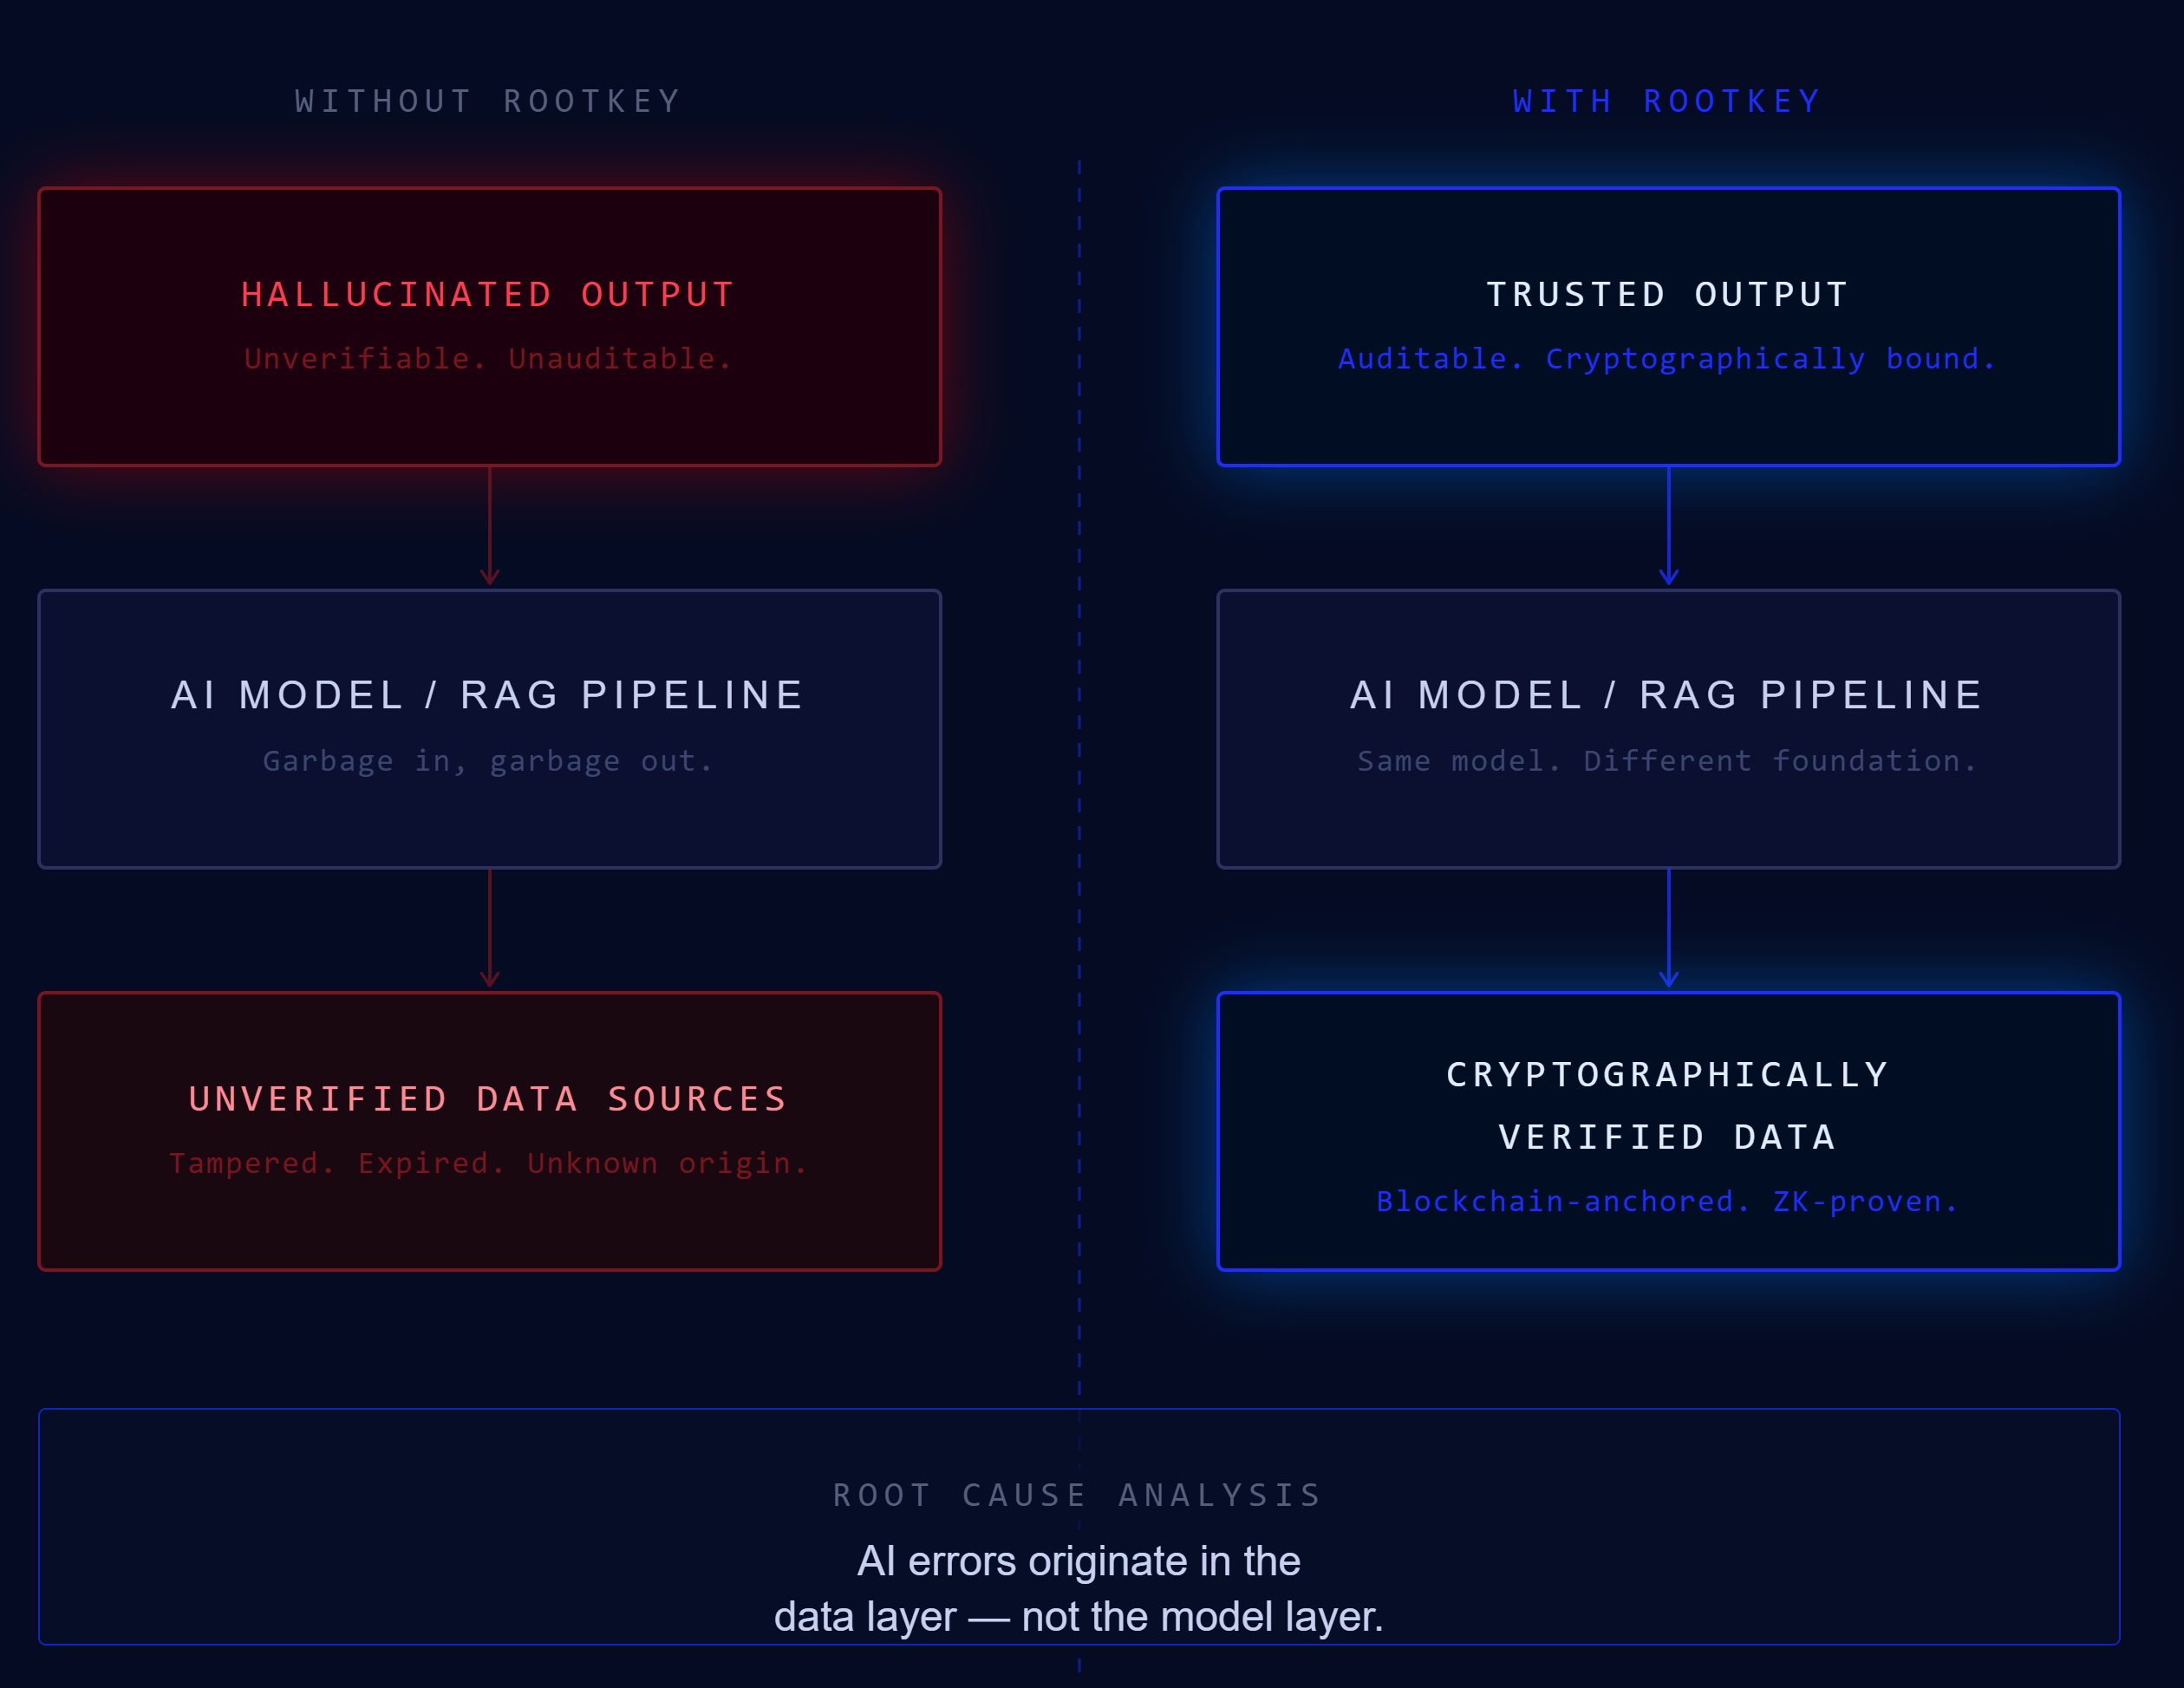
...o resultado é um disparate dito com toda a confiança. O modelo está a fazer exatamente aquilo para que foi construído - gerar texto coerente e adequado ao contexto. A falha está a montante, na camada de dados.
O problema da recuperação nos sistemas RAG
Os sistemas de geração aumentada por recuperação (Retrieval-Augmented Generation, RAG) deviam resolver o problema das alucinações, fundamentando os resultados da IA na recuperação de dados em tempo real em vez de num treino estático. E ajudam, de facto - quando os dados recuperados são fiáveis.
Mas a maioria das implementações empresariais de RAG recupera dados de repositórios de documentos, bases de conhecimento e bases de dados internas que não têm qualquer camada de verificação de integridade. Não existe nenhum mecanismo para detetar se um documento recuperado foi modificado desde que foi indexado. Não há forma de saber se um documento de política foi discretamente atualizado na terça-feira passada, se uma referência regulamentar foi corrompida por um erro de armazenamento, ou se um agente de ameaça injetou informação falsa no corpus de recuperação.
O resultado: o modelo recupera dados comprometidos, trata-os como fidedignos e gera um resultado errado com elevada confiança. O sistema está a funcionar na perfeição. O problema são os dados com que está a trabalhar.
É por isso que a verificação da integridade dos dados não é uma funcionalidade de segurança acrescentada por cima dos sistemas de IA - é um pré-requisito para sistemas de IA em que as organizações possam realmente confiar.
Porque é que atualizar o modelo não resolve um problema de dados
O setor da IA gasta milhares de milhões em melhorias dos modelos: janelas de contexto maiores, melhores arquiteturas de raciocínio, ajuste fino mais robusto. Estes avanços são importantes. Mas não conseguem resolver o problema da proveniência dos dados.
Um modelo mais capaz que recupera dados não verificados não produzirá menos alucinações, mas sim alucinações mais convincentes. A mesma confiança que torna os grandes modelos úteis é a propriedade que torna os seus erros perigosos.
A solução tem de começar na camada de dados. Concretamente:
Impressão digital criptográfica - cada documento, conjunto de dados e ativo de dados que entra num pipeline de IA deve ter um hash que torne evidente qualquer adulteração, ancorado num registo independente. Qualquer modificação - intencional ou acidental - é imediatamente detetável.
Rastreio da proveniência - o sistema de IA deve conseguir responder a 'de onde veio isto e foi alterado desde que foi ingerido?' para cada dado que utiliza.
Monitorização contínua da integridade - as verificações estáticas no momento da ingestão não bastam. Os dados nos repositórios de recuperação têm de ser monitorizados continuamente, e não apenas no momento do carregamento.
A infraestrutura de confiança verificável da ROOTKey fornece exatamente esta base - permitindo às empresas construir sistemas de IA sobre dados em que podem realmente confiar. Comece com uma conta gratuita e ancore o seu primeiro ativo de dados em menos de cinco minutos.
- Audite todas as fontes de dados que alimentam os seus sistemas de IA - quando foram verificadas pela última vez? Consegue detetar se mudarem?
- Nos sistemas RAG, implemente hashing criptográfico na ingestão e volte a verificar no momento da recuperação.
- Trate a proveniência dos dados como um requisito de conformidade, e não como um extra de engenharia.
- Leia a nossa análise mais aprofundada sobre a razão pela qual a integridade dos dados desde a conceção é a abordagem arquitetónica certa desde o primeiro dia.