引言
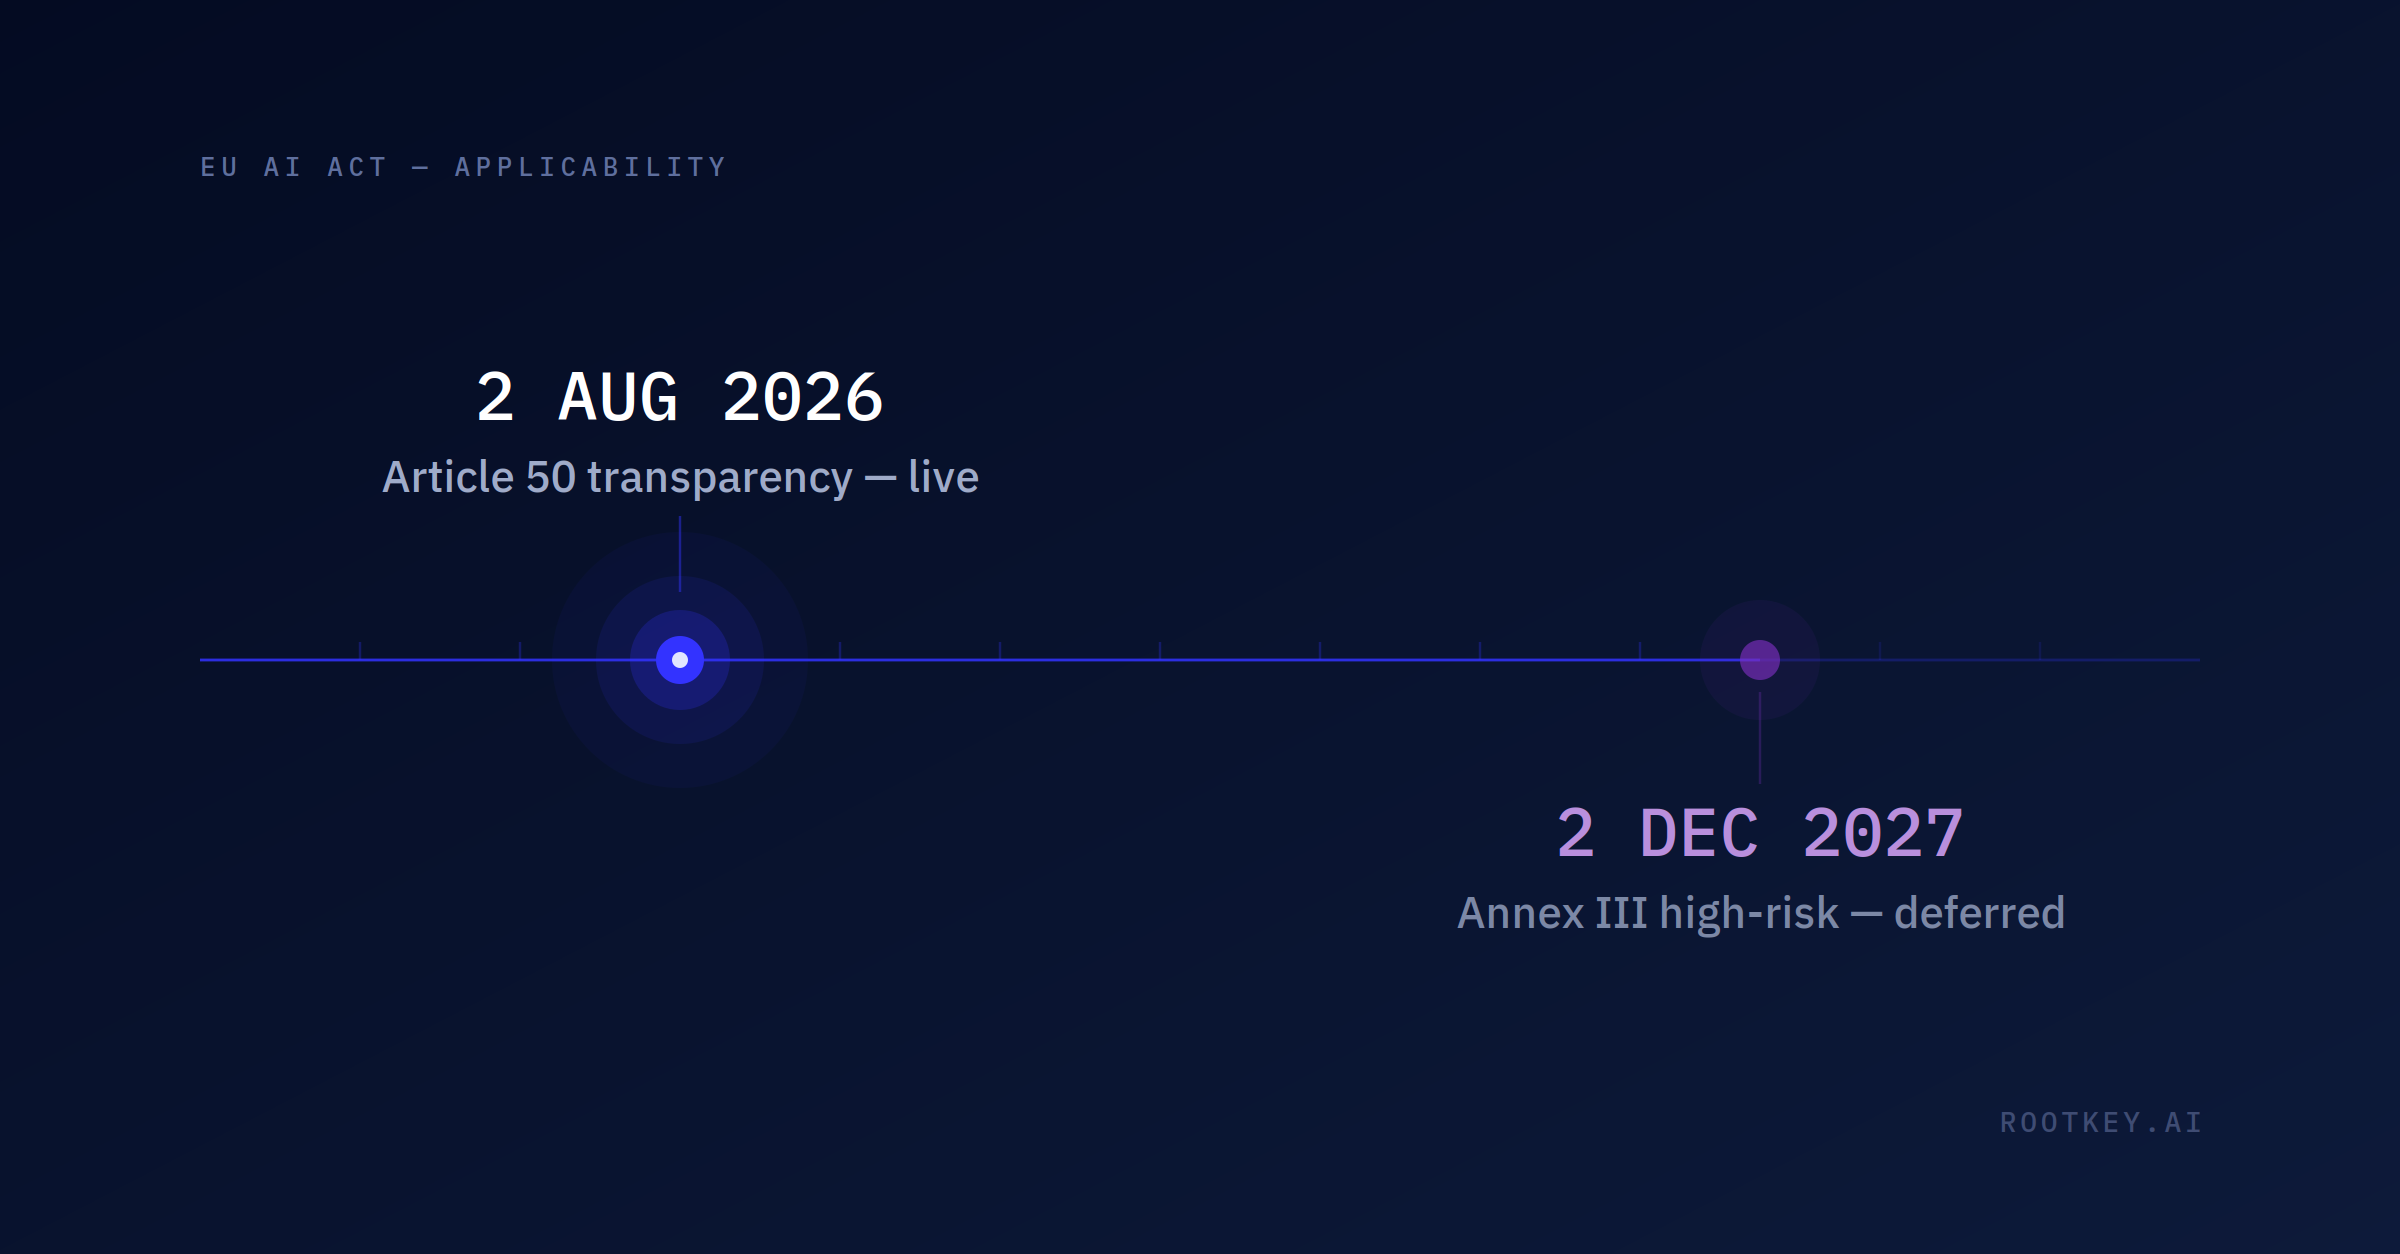
两年来,2026年8月2日一直被圈在合规日历上,被视为欧盟《人工智能法》(AI Act) 高风险义务开始生效的日期。这一说法已不再准确,而它给企业团队造成的困惑本身就是一种风险。2026年6月,欧盟同意推迟高风险人工智能系统的合规时间表:独立系统推迟16个月,嵌入产品的系统推迟12个月,从而将该截止日期推至2027年12月。没有变化的是第50条:聊天机器人的透明度义务、人工智能生成内容的标注以及深度伪造的披露,还有欧盟委员会对通用人工智能模型的执法权力,这两者自本月起均已成为具有约束力的法律。
自2026年8月2日起真正可执行的内容
第50条透明度义务
任何部署聊天机器人、生成合成音频、图像、视频或文本内容的系统,或情绪识别、生物特征分类系统的组织,现在都负有向最终用户披露这一事实的约束性义务。可能被误认为真实材料的人工智能生成内容,必须以机器可读的方式标记为人工智能生成,深度伪造必须附有明确的披露说明。无论底层系统是否被归类为高风险,这一要求均适用。
对通用人工智能模型的执法权力
欧盟委员会针对通用人工智能模型提供者执行相关义务的权力(包括涵盖最大型基础模型的系统性风险层级)也自该日期起生效。基于通用模型进行构建的企业会承接下游文档义务,即使其自身用例未被归类为高风险。
哪些内容被推迟,以及为何推迟并不意味着“等待”
高风险系统的期限现已延至2027年12月
独立的高风险系统(涵盖生物特征识别、关键基础设施、教育和职业培训、就业决策、信用评分和保险等基本服务的获取、执法、移民以及司法行政)获得了额外16个月。受现行欧盟产品安全法律管辖的嵌入产品的高风险系统,例如医疗器械、玩具和电梯,获得了额外12个月。两项义务都不会消失;它们仍将到来,而且监管机构现已明确了时间表。
现在就应着手落实第10条的数据治理要求
当高风险义务真正落地时,第10条要求训练、验证和测试数据集具有相关性、足够的代表性,并在可能的范围内没有错误,同时具备与系统预期用途相适应、有文档记录的数据治理和管理实践。这不是部署前一次性完成的打勾式工作;它需要一份持续的、经得起审查的记录,说明是哪些数据训练了该系统、这些数据来自何处,以及此后是否被修改过。在2027年12月截止日期前的最后几个月里事后补建这条证据链,比现在趁仍有缓冲时间将其构建到数据管道中要困难得多。
- 现已生效:第50条规定的聊天机器人和人工智能内容披露义务
- 现已生效:欧盟委员会对通用人工智能模型的执法权力
- 推迟至2027年12月:独立高风险系统的义务(延期16个月)
- 推迟至约2027年12月:嵌入产品的高风险系统(延期12个月)
- 保持不变:第10条中基本的数据治理门槛,仍然要求数据集来源有文档记录且经得起审查
把推迟当作可以等待的许可,是本季度企业人工智能团队最常犯的错误。最重要的义务(经得起审查、可持续验证的数据治理)恰恰是需要最长时间才能妥善构建的。了解 ROOTKey 如何锚定人工智能训练和推理数据,实现持续、可随时审计的验证。