引言
“AI 就绪数据”已经成了这样一种说法:使用它的人需要它是什么意思,它就是什么意思。对数据平台供应商而言,它通常意味着整洁的数据模式和完善的文档。对模型提供商而言,它往往意味着足够的数据量和多样性。但当监管机构、审计师或事件调查人员提出一个窄得多的问题时,这两种定义都经不起检验:您能否现在就证明,这个系统究竟是用哪些数据训练的、或正在基于哪些数据运行,并且自这些数据获准使用以来,其中没有任何内容发生过变化?
传统定义没有错,只是不完整。
干净、标注良好且具有足够代表性的数据,对模型质量无疑至关重要,欧盟《人工智能法》(AI Act) 第 10 条就明确指出了这一点。但质量与完整性是两种不同的属性。一个数据集在汇集完成当天可能完全干净、均衡且文档齐全,但如果无法证明它此后没有被篡改、补充或悄悄更换了数据来源,六个月后它仍然可能站不住脚。大多数“AI 就绪”检查清单止步于数据集汇集完成的那一刻。可审计性从那一刻开始,并且永不停止。
一个可操作的定义
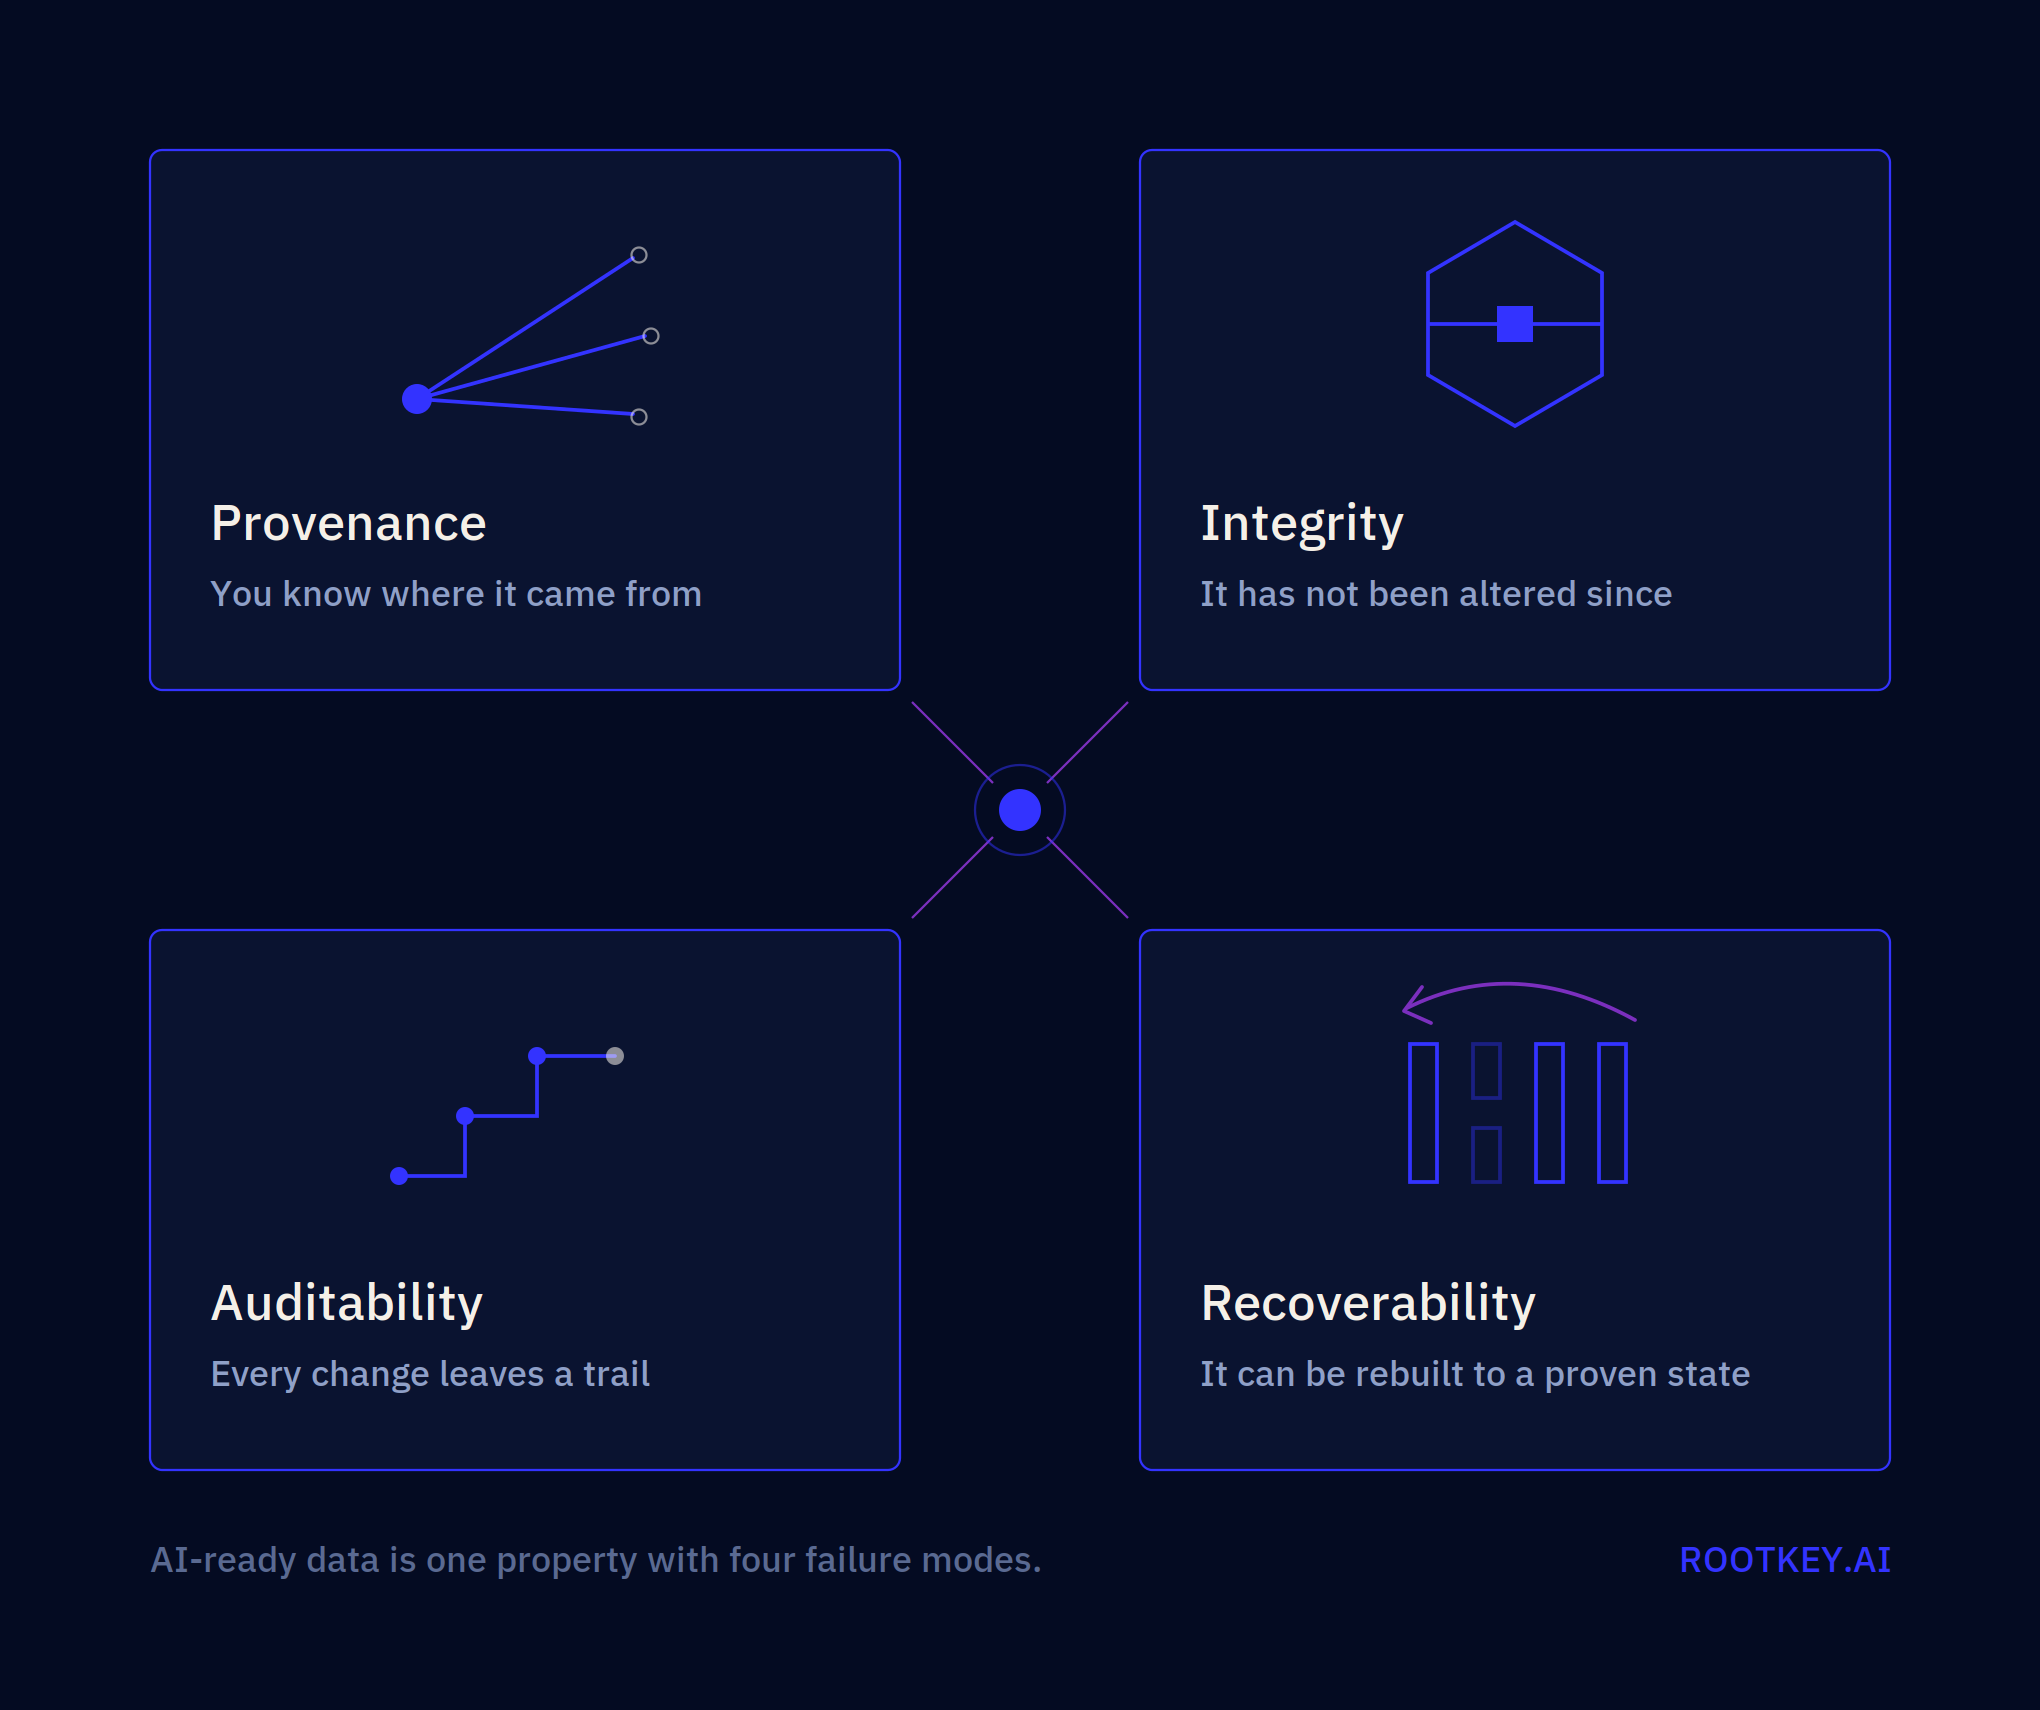
数据满足以下四项属性,并且持续满足,才算 AI 就绪
第一,溯源:每条记录的来源都有文档记录且可验证,而不只是一种声明。第二,不可变性证据:自认证以来对数据集的任何更改,都能通过密码学手段检测出来,而不只是记录在一个本身也可能被篡改的数据库中。第三,访问可问责性:每一个接触过这些数据的主体及其接触时间,都是永久记录的一部分。第四,可复现性:基于数据集经认证的状态,用于训练或微调某个特定模型版本的确切数据可以按需重建,而不是凭记忆或依据事后编写的文档进行近似还原。
为什么“有文档记录”与“可验证”不是一回事
一份描述训练数据来源的电子表格是文档。它由希望审计顺利通过的同一方编写,而且事后可以被修改而不留任何痕迹。可验证的溯源意味着,来源记录在数据摄取的那一刻就已固定下来,独立于被审计方,并且日后无法在不留下修订证据的情况下被悄悄修改。这一区别,即一项声明与一项无法被悄悄更改的声明之间的区别,正是合规叙述与合规证据之间的全部差异。
- 溯源:这条记录源自何处?这一来源能否得到证明,而不只是被声称?
- 不可变性证据:如果这条记录在认证后发生了变化,这一变化能否通过密码学手段被检测出来?
- 访问可问责性:对于每一个接触过这些数据的主体,是否存在一份永久记录,且任何篡改都会在其中留下痕迹?
- 可复现性:任何特定模型版本背后的确切数据集,能否按需重建?
“AI 就绪”正迅速成为一个合规术语,而不仅仅是一个数据质量术语。依据欧盟《人工智能法》、NIS2 以及各行业 AI 治理规则开展的审计已经到来,无法证明自身历史的数据将经不起这些审计。了解 ROOTKey 如何持续锚定数据的溯源信息与完整性,而不仅仅是在采集之时。