错误的诊断正让企业损失数百万
每周都有又一个企业 AI 部署在发生幻觉事件后被撤回。法务团队收到的合同摘要中出现了捏造的条款。财务部门拿到的风险报告中引用了虚构的监管条文。合规负责人发现,自己的 AI 助手引用了一项根本不存在的法规。
人们的第一反应是归咎于模型:更新权重,更换供应商,增加更多护栏。但在大多数情况下,问题并不在模型,而在数据。
幻觉 - 即表述笃定、听起来合理但与事实不符的 AI 输出 - 主要是数据溯源的失效。理解这一区别并非纸上谈兵,它决定了组织应当把投资投向何处,才能构建真正值得信赖的 AI 系统。
幻觉究竟是什么
当 AI 模型生成的输出并非基于可验证的事实时,就会出现幻觉。通常的解释是,模型在缺乏理解的情况下“补全模式”。这种说法没错,但并不完整。
更有用的解释是:模型的准确性不可能超过其训练所用的数据,在检索增强系统中,也不可能超过它在推理时检索到的数据。当这些数据存在以下问题时:
- 过时 - 法规已经变更,模型仍在引用旧版本
- 遭篡改 - 上游数据源被修改却未被发现
- 不一致 - 不同文档相互矛盾,模型对其取平均
- 来源不明 - 模型无法区分权威来源与低质量来源
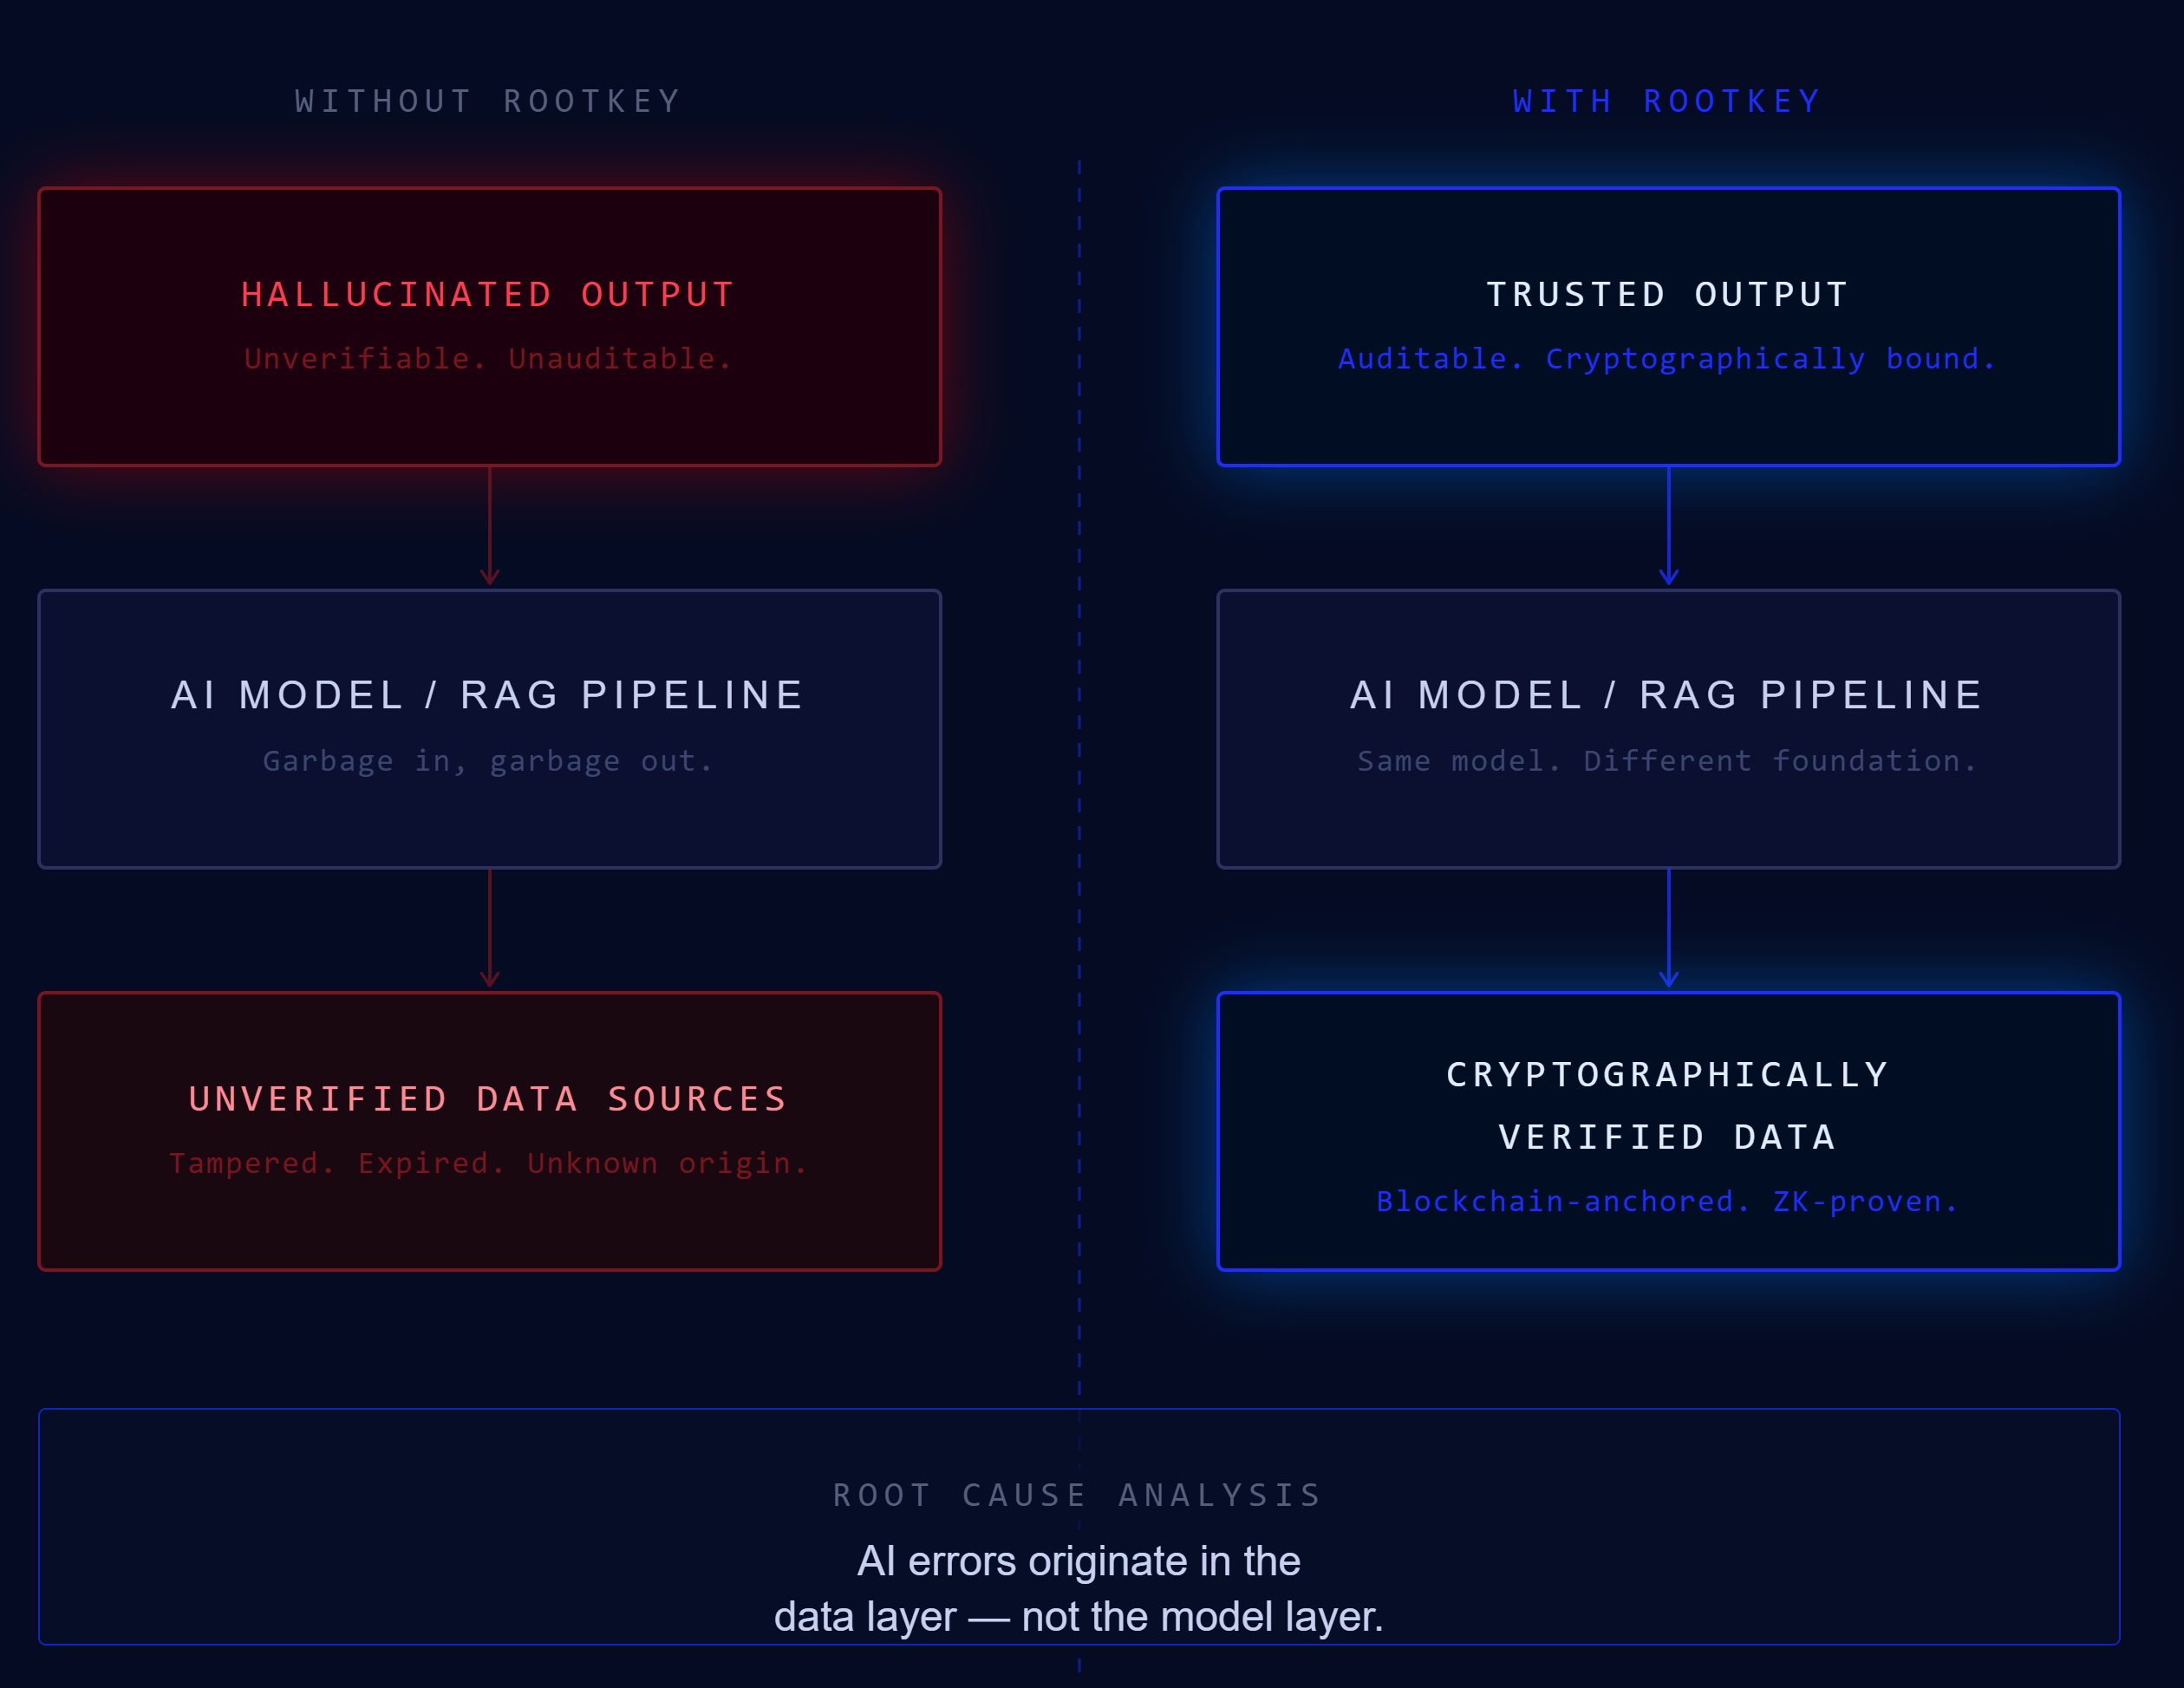
...结果就是言之凿凿的胡言乱语。模型所做的恰恰是它被设计来做的事 - 生成连贯且符合上下文的文本。问题出在上游,即数据层。
RAG 系统中的检索问题
检索增强生成(Retrieval-Augmented Generation,RAG)系统本应通过实时数据检索而非静态训练来为 AI 输出提供依据,从而解决幻觉问题。它们确实有帮助 - 前提是检索到的数据值得信赖。
但大多数企业 RAG 部署所检索的文档存储、知识库和内部数据库都没有任何完整性验证层。没有任何机制能够检测检索到的文档自编入索引以来是否被修改过。无从得知某份政策文件是否在上周二被悄悄更新,某条监管引用是否因存储错误而损坏,或者是否有威胁行为者向检索语料库注入了虚假信息。
结果是:模型检索到已遭破坏的数据,将其视为权威信息,并以高置信度生成错误的输出。系统运行得完美无缺,问题在于它所处理的数据。
正因如此,数据完整性验证并不是叠加在 AI 系统之上的一项安全功能,而是构建组织真正可以依赖的 AI 系统的先决条件。
为什么模型更新无法解决数据问题
AI 行业在模型改进上投入了数十亿资金:更大的上下文窗口、更好的推理架构、更稳健的微调。这些进步很重要,但它们无法解决数据溯源问题。
一个能力更强的模型如果检索的是未经验证的数据,只会产生更具说服力的幻觉,而不是更少的幻觉。让大模型变得有用的那份笃定,恰恰也是让其错误变得危险的特性。
解决方案必须从数据层入手。具体而言:
加密指纹 - 进入 AI 管道的每份文档、每个数据集和每项数据资产,都应具有一个能够暴露任何篡改的哈希值,并锚定到独立的账本上。任何修改 - 无论有意还是无意 - 都能被立即发现。
溯源追踪 - 对于所使用的每一项数据,AI 系统都应能够回答“它来自哪里?自摄取以来是否发生过变化?”
持续完整性监控 - 仅在摄取时进行静态检查是不够的。检索存储中的数据必须持续受到监控,而不仅仅是在上传的那一刻。
ROOTKey 的可验证信任基础设施恰好提供了这一基础,帮助企业在真正可信的数据之上构建 AI 系统。免费注册账户开始使用,不到五分钟即可锚定您的第一项数据资产。
- 审核为您的 AI 系统提供数据的每一个数据源 - 它最近一次验证是在什么时候?如果它发生变化,您能否检测到?
- 对于 RAG 系统,在摄取时实施加密哈希,并在检索时重新验证。
- 将数据溯源视为一项合规要求,而不是工程上可有可无的锦上添花。
- 阅读我们的深度分析,了解为什么通过设计实现数据完整性从第一天起就是正确的架构方法。