Introdução
«Dados prontos para IA» tornou-se uma daquelas expressões que significam aquilo que quem as usa precisa que signifiquem. Para um fornecedor de plataformas de dados, significa normalmente esquemas limpos e boa documentação. Para um fornecedor de modelos, significa muitas vezes volume e diversidade suficientes. Nenhuma das definições resiste ao contacto com um regulador, um auditor ou um investigador de incidentes que faz uma pergunta muito mais restrita: consegue provar, neste momento, exatamente com que dados este sistema foi treinado ou está a operar, e que nada neles mudou desde que foram aprovados para utilização?
A definição convencional não está errada. Está incompleta.
Dados limpos, bem rotulados e suficientemente representativos importam, sem dúvida, para a qualidade de um modelo - o artigo 10.º do Regulamento da Inteligência Artificial da UE (AI Act) di-lo explicitamente. Mas qualidade e integridade são propriedades diferentes. Um conjunto de dados pode estar perfeitamente limpo, equilibrado e bem documentado no dia em que é constituído e, ainda assim, ser indefensável seis meses depois, se não houver forma de provar que, entretanto, não foi alterado, complementado ou discretamente obtido de novas fontes. A maioria das listas de verificação de «prontidão para IA» termina no momento da constituição. A auditabilidade começa aí e nunca termina.
Uma definição operacional
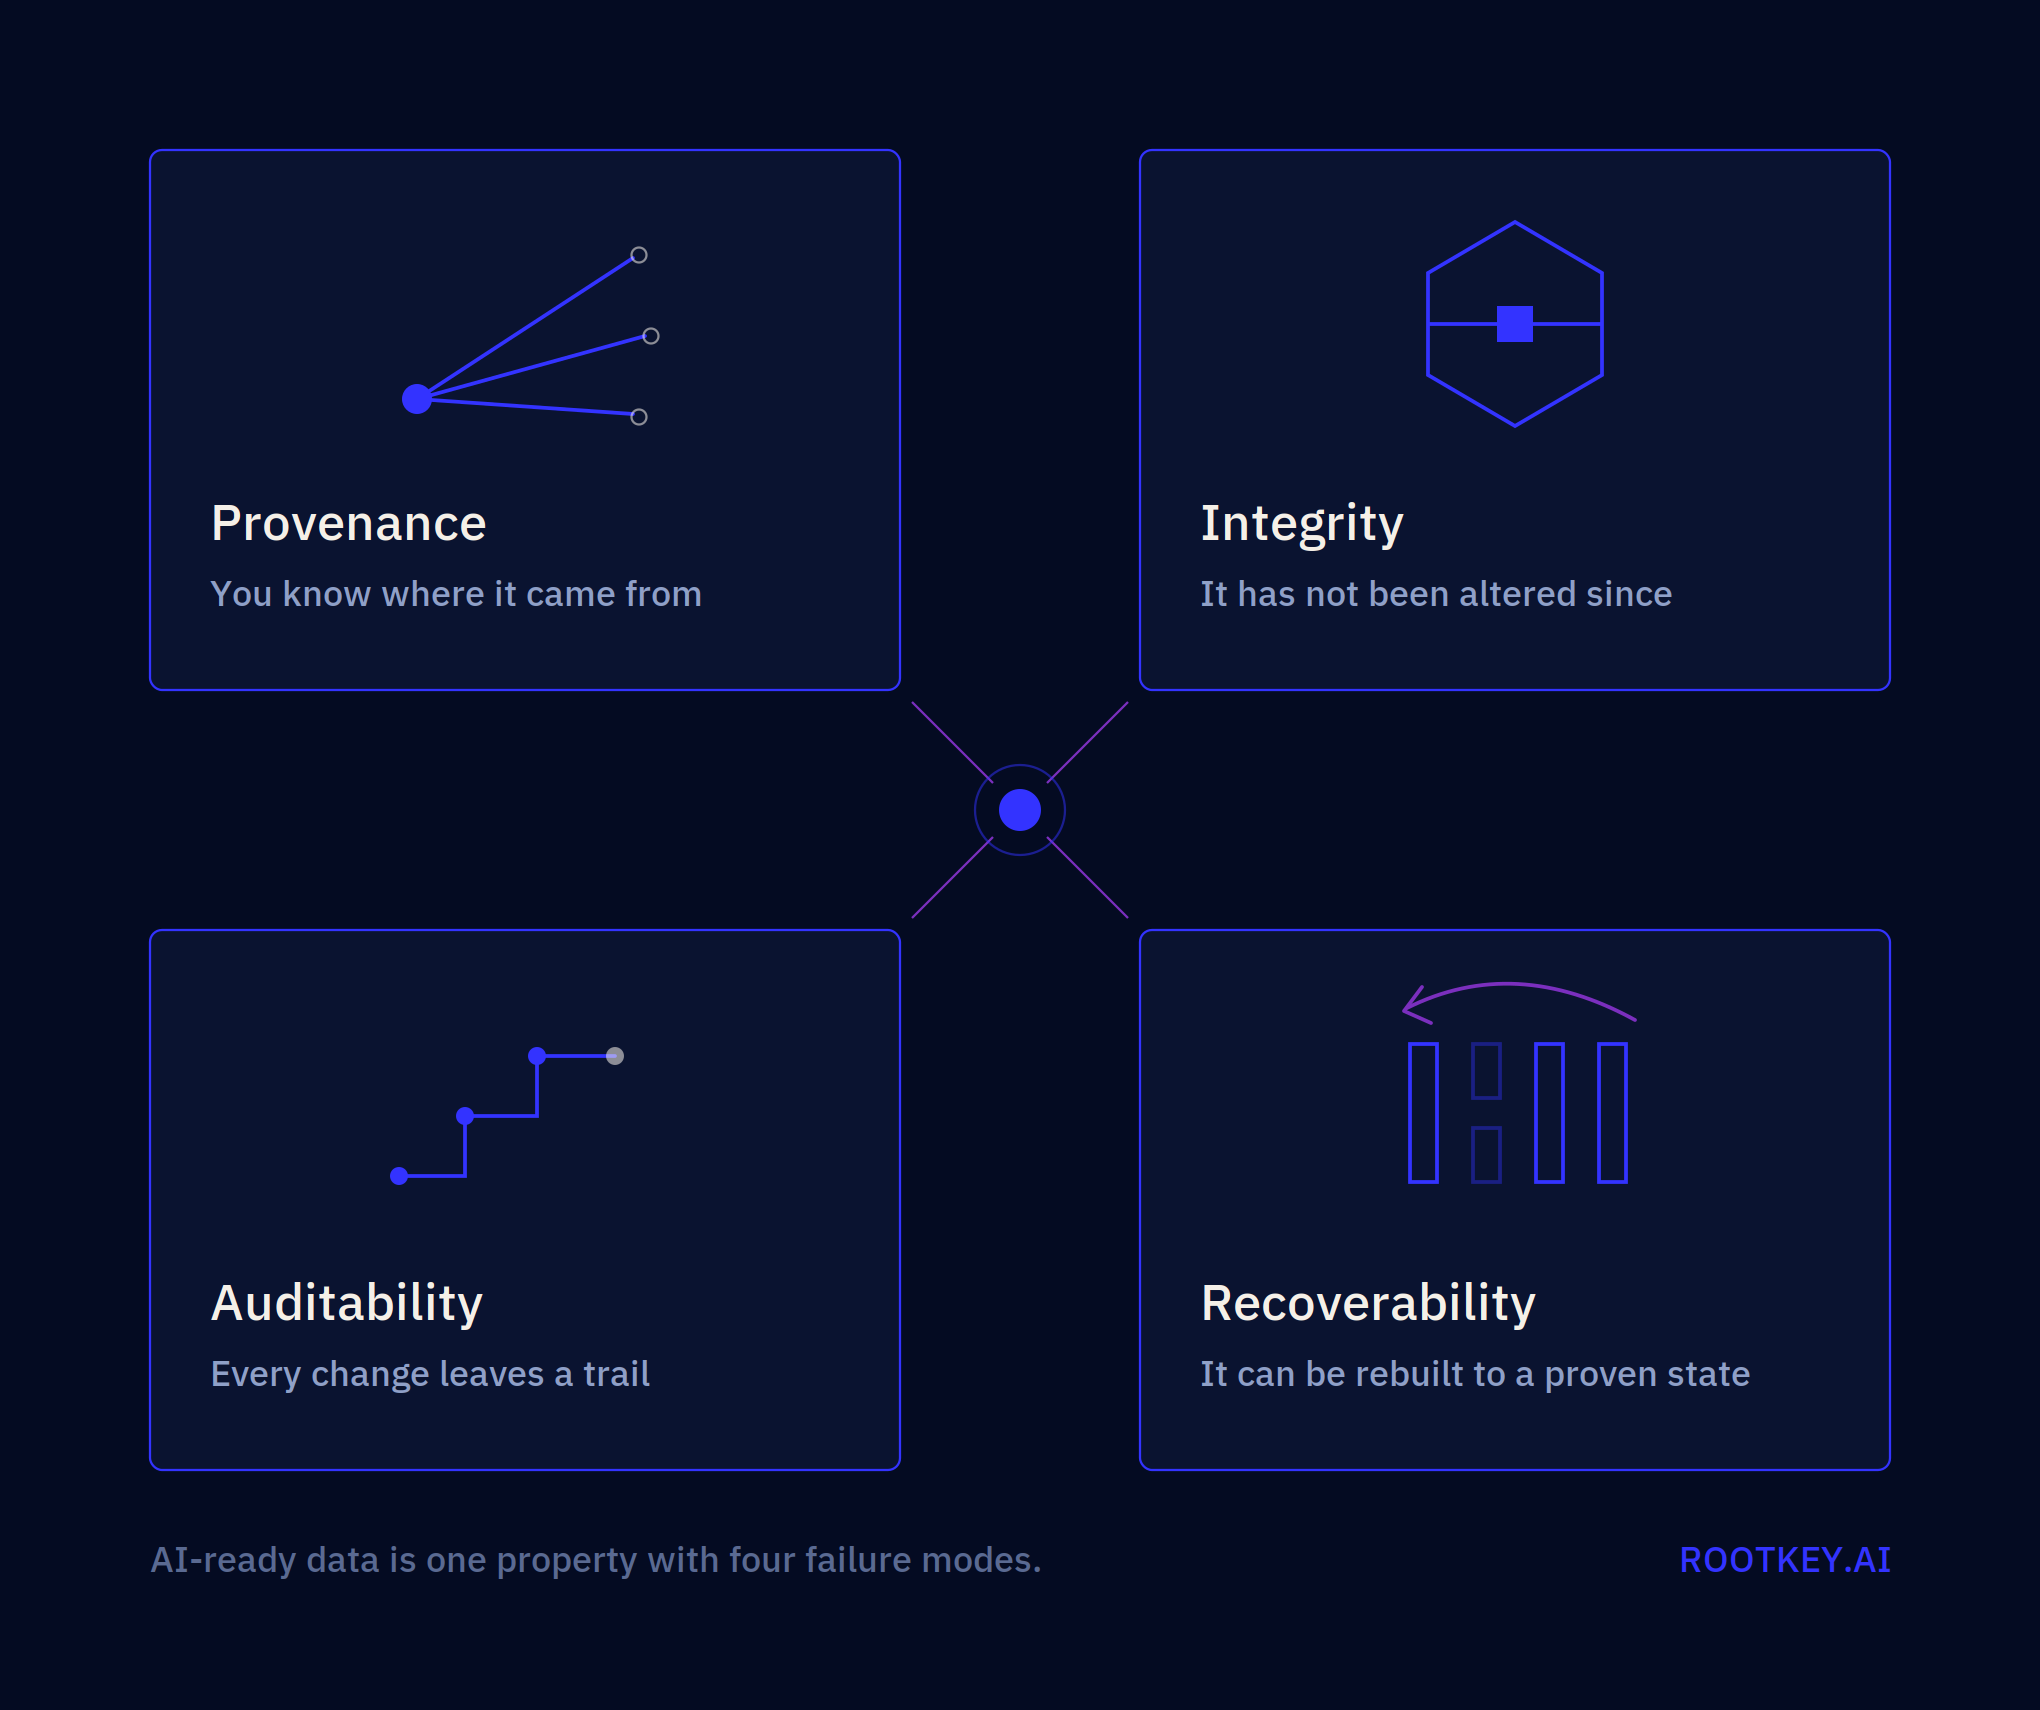
Os dados estão prontos para IA quando cumprem quatro propriedades, de forma contínua
Primeiro, proveniência: a origem de cada registo está documentada e é verificável, e não apenas afirmada. Segundo, evidência de imutabilidade: qualquer alteração ao conjunto de dados desde a certificação é detetável criptograficamente, e não apenas registada numa base de dados que pode, ela própria, ser alterada. Terceiro, responsabilização pelo acesso: todas as partes que tocaram nos dados, e o momento em que o fizeram, fazem parte do registo permanente. Quarto, reprodutibilidade: a partir do estado certificado do conjunto de dados, os dados exatos usados para treinar ou afinar uma determinada versão de um modelo podem ser reconstituídos a pedido, e não aproximados de memória ou a partir de documentação redigida a posteriori.
Porque é que «documentado» e «verificável» não são a mesma palavra
Uma folha de cálculo que descreve de onde vieram os dados de treino é documentação. É redigida pela mesma parte que tem interesse em que a auditoria seja aprovada, e pode ser editada a posteriori sem deixar rasto. Proveniência verificável significa que o registo da origem foi fixado no momento da ingestão, de forma independente da parte auditada, de um modo que não pode ser discretamente revisto mais tarde sem deixar evidência dessa revisão. Essa distinção - entre uma afirmação e uma afirmação que não pode ser alterada em silêncio - é toda a diferença entre uma narrativa de conformidade e evidência de conformidade.
- Proveniência: onde teve origem este registo, e essa origem pode ser provada em vez de apenas afirmada?
- Evidência de imutabilidade: se este registo mudasse após a certificação, essa alteração seria detetável criptograficamente?
- Responsabilização pelo acesso: existe um registo permanente, que torne evidente qualquer adulteração, de todas as partes que tocaram nestes dados?
- Reprodutibilidade: é possível reconstituir a pedido o conjunto de dados exato por detrás de qualquer versão específica de um modelo?
«Pronto para IA» está a tornar-se rapidamente um termo de conformidade, e não apenas de qualidade de dados. Os dados que não conseguem provar o seu próprio historial não resistirão às auditorias que já estão a chegar ao abrigo do AI Act da UE, da NIS2 e das regras setoriais de governação da IA. Veja como a ROOTKey ancora a proveniência e a integridade dos dados de forma contínua, e não apenas no momento da recolha.